Inferencia Híbrida de LLMs con vLLM y Speculative Decoding

La inferencia híbrida con vLLM y la decodificación especulativa es una arquitectura de aceleración a nivel de software que optimiza la velocidad de generación de texto en modelos de lenguaje sin alterar la precisión del razonamiento original ni demandar una ampliación física de la infraestructura. Esta metodología de desarrollo es indispensable en la actualidad porque el despliegue comercial e industrial de arquitecturas autorregresivas gigantes se topa con un severo cuello de botella físico condicionado por el ancho de banda de la memoria; cada token emitido obliga al hardware a leer gigabytes de pesos desde la VRAM, forzando a la GPU a permanecer inactiva esperando la transferencia de datos durante la mayor parte del ciclo computacional.
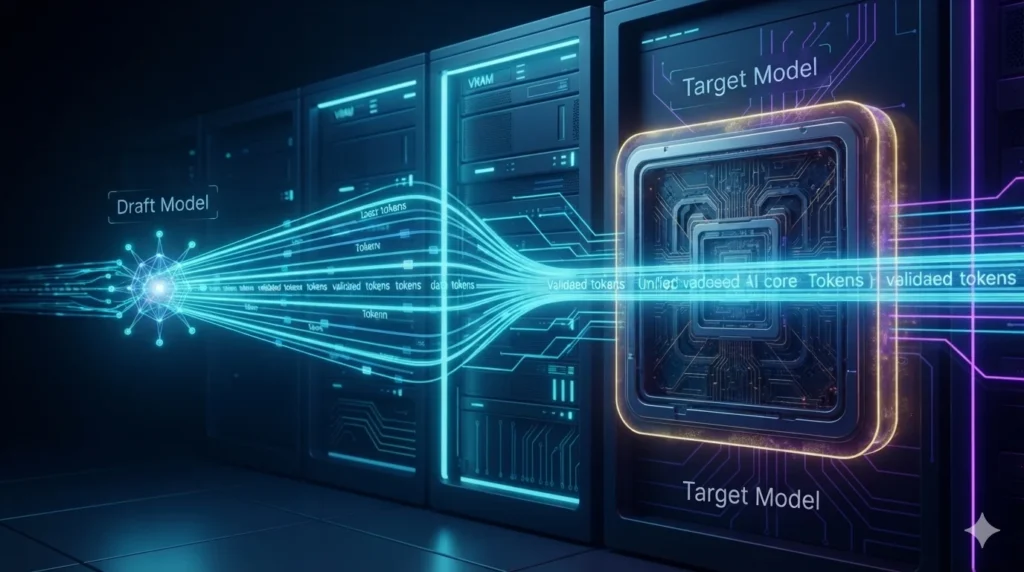
Para erradicar esta ineficiencia y triplicar el rendimiento en entornos locales y distribuidos, el sistema acopla en paralelo un modelo borrador ligero con un modelo objetivo de alta capacidad. El modelo borrador genera rápidamente ráfagas de tokens candidatos en una fracción de milisegundo, los cuales son validados simultáneamente por el modelo principal en una única pasada hacia adelante. Para evitar que la acumulación de datos históricos de la conversación congestione la tarjeta gráfica, la integración nativa del motor de código abierto vLLM inyecta la tecnología PagedAttention, inspirada en la paginación de memoria virtual de los sistemas operativos tradicionales.
Esta capa virtual organiza el búfer de atención en bloques físicos no contiguos dentro de la VRAM, reduciendo el desperdicio de memoria dinámica a cero. Implementar este pipeline avanzado de inferencia en este año 2026 erradica la fragmentación interna del hardware, faculta el procesamiento masivo de solicitudes concurrentes aumentando el tamaño de los lotes y garantiza una tasa de fotogramas semánticos fluida, permitiendo exprimir el potencial de algoritmos complejos de inteligencia artificial bajo presupuestos controlados y arquitecturas totalmente escalables.
El cuello de botella autorregresivo y la solución especulativa
En la generación estándar de texto, un LLM opera de forma estrictamente secuencial: para generar un nuevo token, la GPU debe procesar el prompt junto con todos los tokens anteriores. Dado que los pesos del modelo deben cargarse desde la VRAM por cada token individual, el ancho de banda de la memoria se convierte en el factor estrangulador de la velocidad.
La decodificación especulativa (Speculative Decoding) rompe esta limitación mediante una arquitectura de dos modelos que colaboran en paralelo:
- Modelo Borrador (Draft Model): Un modelo pequeño y liviano (por ejemplo, de 1B a 3B de parámetros) de la misma familia arquitectónica. Este modelo es sumamente rápido porque sus pesos ocupan muy poco espacio en la VRAM.
- Modelo Objetivo (Target Model): El modelo principal de alta capacidad (por ejemplo, de 70B de parámetros) del cual deseamos obtener las respuestas con máxima precisión de razonamiento.
El flujo de trabajo opera bajo un ciclo especulativo:
- Fase de Especulación: El modelo draft genera rápidamente una ráfaga de varios tokens candidatos de forma autorregresiva en una fracción de milisegundo.
- Fase de Verificación Paralela: Los tokens candidatos se envían en un único lote (batch) al modelo target. El modelo target ejecuta una sola pasada hacia adelante (forward pass) para evaluar la distribución de probabilidad de los tokens simultáneamente.
- Fase de Aceptación / Rechazo: Se aplica un criterio de muestreo estocástico para validar cuántos tokens de la ráfaga especulada son idénticos o probabilísticamente aceptables para el modelo principal.
Si el modelo target acepta la mayoría de los tokens especulados, el sistema emite esos tokens más un token corregido adicional producido por el modelo principal en esa misma pasada. En lugar de ejecutar múltiples lecturas completas de la VRAM, la GPU ha generado varios tokens con la carga de memoria de una sola pasada del modelo gigante.
El principio de la Aceptación Modificada
Para garantizar que el texto generado por la decodificación especulativa mantenga la misma distribución de probabilidad exacta que si el modelo target hubiera generado el texto solo, se utiliza un algoritmo de verificación estocástica.
El sistema compara la probabilidad asignada a cada token por el modelo borrador con la probabilidad asignada por el modelo objetivo. Si el modelo objetivo asigna una probabilidad igual o superior a la del modelo borrador, el token se acepta de inmediato. Si la probabilidad es inferior, el token puede ser rechazado según una proporción directa entre ambas probabilidades.
En caso de que un token sea rechazado, la especulación de esa ráfaga se detiene en ese punto exacto, el token es descartado y el modelo objetivo genera el token correcto directamente. Este mecanismo garantiza de forma estricta que el resultado final sea conceptual y estadísticamente idéntico a una inferencia tradicional ejecutada únicamente por el modelo principal.
vLLM y PagedAttention: Gestión de Memoria Virtual para KV-Cache
El segundo pilar de la inferencia de ultra-alta velocidad es la gestión de la KV-Cache (Caché de Claves y Valores). En la atención de los Transformers, se almacenan los vectores de clave y valor de todos los tokens previos para evitar recalcularlos.
En los motores tradicionales, la memoria de la KV-Cache debe reservarse en bloques contiguos de VRAM para el tamaño máximo de contexto posible. Esto provoca dos problemas graves:
- Fragmentación Externa: Incapacidad de usar espacio libre no contiguo.
- Fragmentación Interna: Hasta un 60%-80% de la VRAM reservada queda desperdiciada esperando texto que el usuario nunca llega a generar.
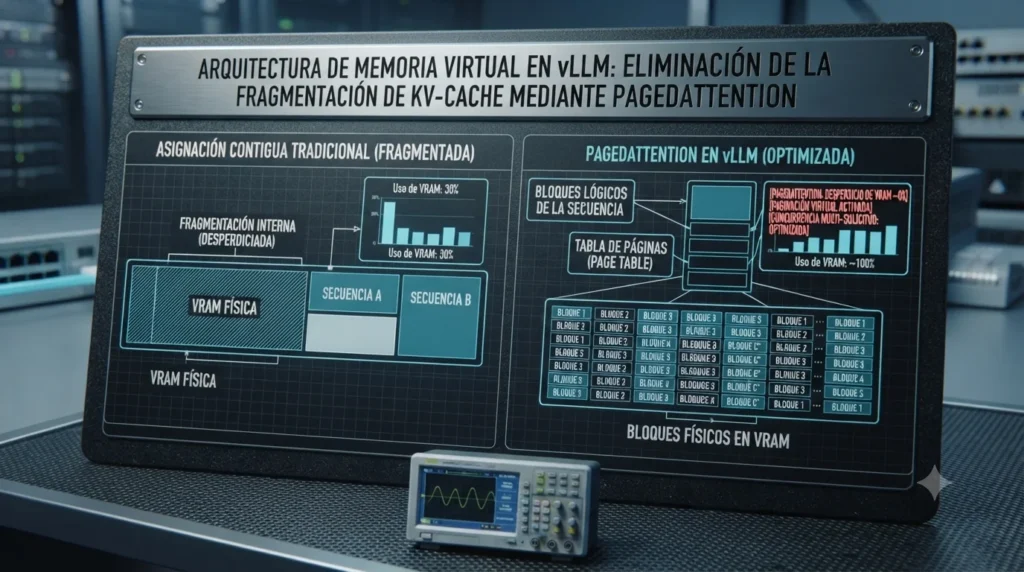
El motor de código abierto vLLM resuelve esto introduciendo PagedAttention, una arquitectura inspirada en la memoria virtual paginada de los sistemas operativos. PagedAttention divide la KV-Cache en bloques físicos no contiguos en la VRAM y utiliza una tabla de páginas (Page Table) para mapear los bloques lógicos de la secuencia de texto.
Gracias a PagedAttention:
- La VRAM utilizada para la KV-Cache se aproxima al 0% de desperdicio.
- Se pueden ejecutar decenas de solicitudes en paralelo aumentando el tamaño del lote (batch size).
- Permite compartir páginas de memoria en la VRAM para secuencias que comparten el mismo prompt de sistema o prefijo, optimizando los tiempos de procesamiento.
Tabla Comparativa
| Técnica de Aceleración | Velocidad (Tokens/s) | Precisión del Razonamiento | Uso de VRAM / Overhead |
| Inferencia Estándar (FP16 / BF16) | Lenta (1x Baseline) | 100% (Sin pérdidas) | Alto (Reserva de VRAM estática e ineficiente) |
| Cuantización Agresiva (INT4 / AWQ) | Rápida (2x - 2.5x) | Degradada (Pérdida de precisión en tareas complejas) | Bajo (Sustancial reducción en tamaño de pesos) |
| vLLM con PagedAttention | Muy Rápida (2x - 3x) | 100% (Sin pérdidas) | Ultra Eficiente (Cero fragmentación de KV-Cache) |
| vLLM + Speculative Decoding | Hiper Rápida (3x - 4.5x) | 100% (Garantía exacta al modelo base) | Leve Overhead (Requiere VRAM extra para el modelo draft) |
Advertencia: Al implementar Speculative Decoding con vLLM en este 2026, asegúrate de que el modelo draft y el modelo target compartan exactamente el mismo tokenizador (tokenizer). Si los vocabularios o el mapeo de IDs de tokens difieren entre ambos modelos, el sistema se verá obligado a ejecutar una des-tokenización y re-tokenización intermedia por software por cada token generado, lo que destruirá el rendimiento y reducirá la velocidad por debajo de la inferencia estándar.
Tasas de aceptación, latencias de inferencia y escalabilidad en VRAM
Para consolidar la eficiencia de un clúster de inteligencia artificial mediante la inferencia híbrida con vLLM, es indispensable comprender cómo interactúan los índices de validación estocástica con las fases de prellenado de tokens, las demandas físicas de memoria de vídeo y las combinaciones de formatos binarios optimizados. La administración avanzada de grandes modelos de lenguaje exige un análisis metodológico profundo que elude las métricas comerciales superficiales, permitiendo identificar cómo mitigar los cuellos de botella de hardware. A continuación, desglosaremos las especificaciones técnicas obligatorias para auditar y asegurar tus entornos de procesamiento semántico:
Dinámicas de alineación algorítmica y la métrica de aceptación
La ganancia real de rendimiento al implementar decodificación especulativa está sujeta a la tasa de aceptación, que mide el porcentaje de tokens del modelo borrador convalidados por el modelo objetivo. Cuando ambos modelos comparten el mismo árbol conceptual y vocabulario, esta métrica se sitúa entre el 70% y el 85%, traduciéndose en una aceleración lineal de la velocidad global.
Sin embargo, si la concordancia cae por debajo del umbral del 30% debido a asimetrías en el tokenizador o a un dominio léxico hiper-especializado, el sobrecoste de computar pasadas de corrección anula el beneficio operativo, degradando el rendimiento por debajo de la inferencia estándar. Para mitigar esto, es obligatorio que ambas redes compartan de forma estricta el mismo diccionario base para evitar conversiones intermedias por software.
Desacoplamiento de latencias entre fases de prefil y decode
El perfil de velocidad en los motores modernos se segmenta en dos indicadores temporales independientes según la etapa del flujo de inferencia. El tiempo al primer token (Time to First Token o TTFT) cuantifica el retardo de cómputo durante la fase de procesamiento inicial del prompt, mientras que el tiempo entre tokens (Time Between Tokens o TBT) mide la cadencia de la emisión autorregresiva continua.
La arquitectura basada en paginación optimiza agresivamente el TBT al suprimir los picos de latencia de la memoria física. Paralelamente, para contener el TTFT en contextos masivos, el motor recurre a la paralelización a nivel de kernel mediante el despliegue del repositorio oficial de FlashAttention-3 Framework, acelerando el cálculo de las matrices de atención en milisegundos.
Dimensionamiento calórico de memoria y asignación de la KV-Cache
El despliegue de infraestructuras híbridas en entornos de producción exige calcular con precisión la sobrecarga de VRAM requerida para sostener la coexistencia de ambos modelos en la misma GPU. El requisito de memoria adicional se limita estrictamente a la suma del tamaño de los pesos del modelo borrador y su búfer de atención dinámico independiente.
En la práctica, si el servidor alberga un modelo principal cuantizado a 8 bits en un nodo de 48 gigabytes, inyectar una variante borradora de pocos miles de millones de parámetros demanda apenas un margen de entre 2 y 4 gigabytes extras. Debido a que la paginación erradica por completo el desperdicio estructural de la caché de claves y valores, el consumo neto final sigue siendo inferior al de los motores convencionales ineficientes.
Sinergia de decodificación con perfiles de cuantización avanzada
La decodificación especulativa opera de forma agnóstica a la representación matemática interna de las neuronas artificiales, ya que evalúa exclusivamente las distribuciones de probabilidad en las capas de salida. Esta independencia lógica faculta a los ingenieros para combinar este método con formatos de cuantización de alta densidad como AWQ o GPTQ.
Es técnicamente viable orquestar un modelo objetivo masivo comprimido a 4 bits junto a un modelo borrador cuantizado de forma homóloga. Al enlazar esta estrategia con la gestión de memoria de vLLM, las organizaciones consiguen ejecutar inteligencias artificiales de escala empresarial en tarjetas gráficas de consumo general, reteniendo altas velocidades de generación sin sacrificar la precisión ni los recursos financieros del clúster de cómputo.
Si quieres conocer otros artículos parecidos a Inferencia Híbrida de LLMs con vLLM y Speculative Decoding puedes visitar la categoría Procesamiento/ IA.
Deja una respuesta
Más contenido relacionado