Agentes de IA con LangGraph y Memoria Persistente

Contenido en esta publicación
- El colapso del paradigma "Chain" y el problema de los bucles infinitos
- LangGraph: Grafos Dirigidos y Máquinas de Estado Finitas
- Memoria Persistente mediante Puntos de Control (Checkpoints)
- Implementación en el Laboratorio: Configuración de un Checkpointer en Python
- Interrupción Controlada: Human-in-the-Loop
- Tabla Comparativa
- Gestión de memoria, instantáneas JSON y optimización en disco
- Divergencias lógicas entre la memoria de sesión y la memoria persistente global
- Versionado de metadatos y mitigación de excepciones en migraciones JSON
- Balance calórico en escrituras masivas y optimización por almacenamiento en memoria
- Contención del tamaño de ventana mediante reductoras de contexto de conversación
El desarrollo de agentes de IA con LangGraph y memoria persistente representa la evolución arquitectónica de la inteligencia artificial corporativa. En el laboratorio de DatoCortex, al desplegar asistentes a gran escala para flujos transaccionales y automatizaciones críticas, comprobamos que el paradigma tradicional de cadenas lineales (Chains) colapsa inmediatamente ante excepciones de red o variaciones en los outputs de los LLMs. Esto provoca bucles de razonamiento infinitos que agotan las cuotas de las APIs en minutos. Para solucionar de raíz esta fragilidad y garantizar la gobernanza del sistema, la arquitectura debe migrar hacia Máquinas de Estado Finitas controladas por Grafos Dirigidos con Estado, donde cada transición se respalde de forma no volátil en disco o memoria principal.
Para solucionar de raíz esta fragilidad e inyectar resiliencia perimetral, el framework de código abierto estructura los flujos en nodos de cómputo especializados y bordes condicionales fuertemente tipados. El control absoluto del contexto de la conversación se confina en una estructura centralizada que interactúa con capas de persistencia no volátiles optimizadas en bases de datos relacionales avanzadas como PostgreSQL Global Development Group o almacenes en memoria ultra veloces como Redis.
Este acoplamiento perimetral registra instantáneas del estado exacto después de la ejecución de cada nodo individual, lo que faculta al sistema para mitigar condiciones de carrera y reanudar flujos interrumpidos. Además, esta persistencia por puntos de control habilita de forma nativa la suspensión temporal de la máquina de estados frente a acciones de alta criticidad, delegando la autorización final en un operador web mediante flujos supervisados. Configurar este pipeline técnico erradica la autonomía ciega del modelo, blinda la infraestructura contra fugas de tokens y garantiza una toma de decisiones auditable y segura.
El colapso del paradigma "Chain" y el problema de los bucles infinitos
Los primeros frameworks de desarrollo para LLMs popularizaron la idea de las cadenas (Chains): secuencias lineales rígidas donde la salida del paso A alimenta la entrada del paso B. Cuando se intentó dar la "autonomía" a un agente utilizando este modelo, se recurrió a bucles abiertos donde el LLM decidía en una iteración continua qué herramienta llamar hasta considerar que la tarea estaba terminada.
En producción, este enfoque probabilístico no supervisado colapsa debido a tres fallos estructurales:
- Bucle de Razonamiento Infinito: Si una herramienta externa devuelve un mensaje de error no esperado o un formato atípico, el LLM suele reintentar exactamente la misma acción con variaciones mínimas de prompt, atascándose en un bucle que agota la cuota de la API.
- Amnesia de Estado en Fallos: Si el proceso sufre una interrupción de red o una caída del servidor en el paso 8 de 10, la ejecución se pierde por completo al residir únicamente en la memoria RAM volátil de la aplicación.
- Ausencia de Gobernanza: Un agente autónomo puro no tiene mecanismos para pausar su ejecución y solicitar la aprobación de un usuario humano antes de ejecutar una acción irreversible (como enviar un correo masivo o procesar un pago).
LangGraph: Grafos Dirigidos y Máquinas de Estado Finitas
LangGraph aborda el problema redefiniendo la orquestación de agentes no como una cadena lineal, sino como un Grafo Dirigido con Estado (Stateful Directed Graph).
La arquitectura se sostiene sobre tres componentes fundamentales:
- El Estado Global (State): Una estructura de datos centralizada y fuertemente tipada que almacena todo el contexto de la ejecución (mensajes, variables de entorno, resultados de herramientas y metadatos). Cada nodo recibe una copia del estado y devuelve las modificaciones que deben aplicarse a dicho estado.
- Nodos (Nodes): Representan las unidades de cómputo. Un nodo puede ser una llamada a un LLM, una función de código Python/TypeScript pura o la ejecución de una consulta a una base de datos.
- Bordes Condicionales (Conditional Edges): La lógica de control del flujo. En lugar de permitir que el agente salte a cualquier parte, los bordes evalúan el estado actual para determinar la ruta hacia el siguiente nodo de forma determinista.
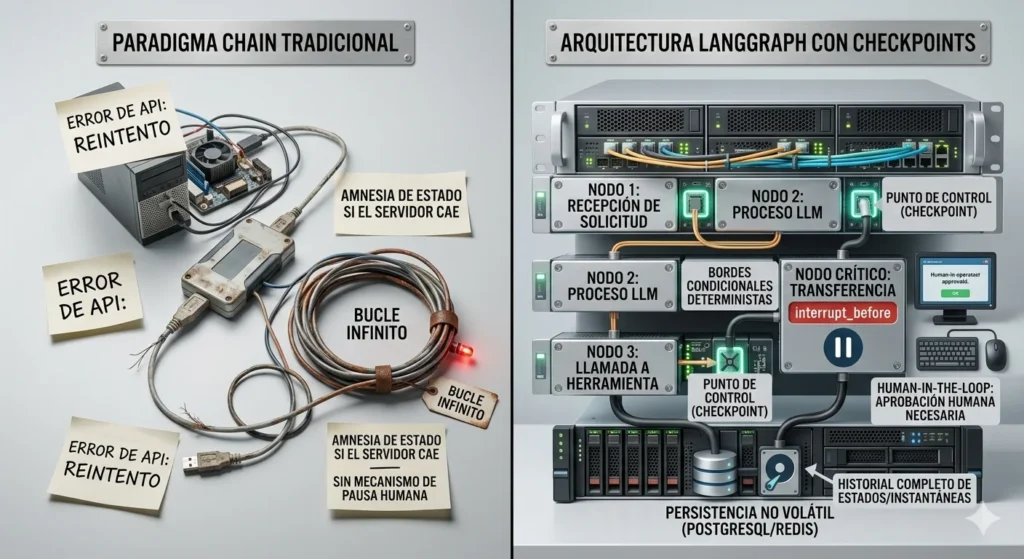
Al definir un número máximo de iteraciones sobre los bordes y establecer caminos de salida explícitos (fallback paths) cuando se detectan anomalías, LangGraph convierte la ejecución probabilística del modelo en una máquina de estados finita. Si el agente falla repetidamente en un nodo, el grafo fuerza la transición hacia un nodo de manejo de errores o finaliza la ejecución de forma limpia.
Memoria Persistente mediante Puntos de Control (Checkpoints)
Para lograr resiliencia de nivel empresarial, LangGraph separa el motor de ejecución del almacenamiento de estado mediante el uso de Checkpointers.
Un Checkpointer es una capa de persistencia que guarda una instantánea (snapshot) del estado del grafo en una base de datos no volátil (como PostgreSQL o Redis) al completar la ejecución de cada nodo individual.
Este esquema desbloquea capacidades críticas para el entorno productivo:
- Tolerancia a Fallos y Reanudación: Si el servidor se reinicia a mitad de un proceso complejo, el agente no vuelve a empezar desde cero. Al reanimar el proceso con el identificador único de hilo (thread_id), el sistema carga la última instantánea desde PostgreSQL o Redis y reanuda el trabajo exactamente en el nodo donde ocurrió el corte.
- Viaje en el Tiempo (Time Travel / State Rollback): Los desarrolladores pueden inspeccionar el historial completo de instantáneas del estado, modificar una variable que causó un error en el pasado y re-ejecutar el grafo desde ese punto específico para corregir el comportamiento.
Implementación en el Laboratorio: Configuración de un Checkpointer en Python
Para demostrar que la resiliencia empresarial de LangGraph no es una abstracción teórica, a continuación desglosamos la infraestructura mínima requerida en Python para instanciar un grafo con persistencia en memoria utilizando MemorySaver. Este esquema replica el comportamiento de producción que posteriormente se escala a bases de datos relacionales robustas como PostgreSQL.
from langgraph.checkpoint.memory import MemorySaver
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages

# 1. Definición del Estado Global fuertemente tipado
class AgentState(TypedDict):
    messages: Annotated[list, add_messages]

# 2. Instanciación del constructor del grafo
builder = StateGraph(AgentState)

# Define un nodo básico de cómputo (Llamada al modelo o herramienta)
def call_model(state: AgentState):
    # Aquí interactúa el pipeline semántico de la infraestructura
    return {"messages": ["Procesando petición en el nodo de laboratorio..."]}

builder.add_node("agent", call_model)
builder.add_edge(START, "agent")
builder.add_edge("agent", END)

# 3. Inyección de la capa de persistencia (Checkpointer)
memory_storage = MemorySaver()

# Compilación de la máquina de estados finitos protegida
app = builder.compile(checkpointer=memory_storage)

# 4. Ejecución del hilo persistente mediante un thread_id único
config = {"configurable": {"thread_id": "datocortex_session_01"}}
events = app.stream({"messages": [("user", "Ejecutar transacción de red")]}, config)

for event in events:
    print(event)
Análisis técnico del pipeline
Al pasar el objeto checkpointer=memory_storage durante la compilación, el motor de LangGraph fuerza un volcado binario del AgentState en cada transición de borde. Si el hilo de ejecución datocortex_session_01 sufre un corte de conexión intermedio, basta con invocar el mismo thread_id en una nueva petición para que el sistema realice un State Rollback o reanude el proceso sin duplicar la consulta inicial al LLM, blindando la infraestructura contra fugas de tokens.
Interrupción Controlada: Human-in-the-Loop
La persistencia de estado por checkpoints es la pieza técnica que habilita el patrón Human-in-the-Loop (Supervisión Humana en el Bucle) de forma nativa.
Mediante la directiva interrupt_before o interrupt_after aplicada a un nodo crítico (por ejemplo, nodo_ejecutar_transferencia), el grafo guarda el estado actual en la base de datos y suspende su ejecución por completo, liberando los recursos del servidor.
El flujo queda a la espera en la base de datos el tiempo que sea necesario (minutos, días o semanas). Cuando un operador humano revisa la solicitud en una interfaz web y emite una aprobación o corrección, el sistema envía un comando de reanudación cargando el punto de control e indicando al grafo que avance al siguiente nodo de la máquina de estados.
Tabla Comparativa
| Parámetro de Arquitectura | Cadenas Tradicionales (Chains / Autonomous Loops) | Grafos de Estado con LangGraph + Checkpoints |
| Control de Flujo | Indeterminista / Propenso a bucles infinitos | Determinista por Grafos Acíclicos y Máquinas de Estado |
| Gestión de Memoria | Memoria RAM volátil en el hilo de ejecución | Persistencia estricta por nodo en Postgres/Redis |
| Recuperación ante Caídas | Inexistente (Reinicia la tarea desde el inicio) | Reanudación exacta desde el último checkpoint guardado |
| Intervención Humana | Difícil de implementar / Requiere bloqueos activos | Nativa (Human-in-the-Loop) mediante pausa de estado |
| Gobernanza y Auditoría | Caja negra / Rastreo complejo en logs plano | Auditoría paso a paso por instantáneas de estado |
Advertencia: Al diseñar esquemas de Checkpoints con PostgreSQL o Redis en este 2026, asegúrate de implementar políticas de caducidad (TTL) o limpieza periódica para los hilos de ejecución finalizados. Guardar la instantánea completa del contexto de conversación y objetos de herramientas en cada nodo de miles de procesos diarios llenará rápidamente el almacenamiento de tu base de datos con gigabytes de datos de estado redundantes.
Gestión de memoria, instantáneas JSON y optimización en disco
Para consolidar la resiliencia en arquitecturas avanzadas impulsadas por agentes de ia con langgraph, es indispensable comprender cómo interactúan las instantáneas del ciclo de ejecución con el ciclo de vida del almacenamiento local, los procesos de transformación estructural del firmware y el rendimiento de I/O en memoria principal. La ingeniería perimetral de sistemas de automatización cognitiva exige un análisis metodológico profundo que eluda los mitos comerciales del desarrollo no supervisado, permitiendo aislar la latencia antes de comprometer la integridad del pool de datos. A continuación, desglosaremos las especificaciones técnicas obligatorias para auditar y asegurar tus grafos de producción:
Divergencias lógicas entre la memoria de sesión y la memoria persistente global
La gestión del contexto se bifurca en dos almacenes independientes según el alcance temporal y el direccionamiento del estado de ejecución. La memoria a corto plazo encapsula los datos exclusivamente dentro de las fronteras lógicas de un hilo específico mediante el control del flujo del grafo, conteniendo las variables efímeras necesarias para la invocación inmediata de APIs y herramientas.
Por el contrario, la memoria a largo plazo opera de forma externa mediante repositorios independientes indexados por vectores o estructuras clave-valor. Este diseño faculta al sistema para capturar preferencias conceptuales, perfiles lógicos y aprendizajes semánticos transversales, permitiendo que las redes neuronales reconozcan el comportamiento del usuario en interacciones futuras desconectadas del flujo original.
Versionado de metadatos y mitigación de excepciones en migraciones JSON
La evolución en la estructura declarativa de las Máquinas de Estado Finitas impone la necesidad de desplegar esquemas adaptativos para la lectura de datos históricos. Cuando los ingenieros de software actualizan el código fuente inyectando nuevas variables obligatorias en el objeto central, los registros de instantáneas antiguas almacenados en producción pueden arrojar excepciones críticas de validación durante la carga del hilo.
Erradicar este fallo estructural exige implementar políticas de versionado estricto en la lógica de serialización binaria. El uso de funciones de transformación en la capa intermedia y la definición de valores predeterminados seguros al deserializar el formato estructurado garantiza que las tareas interrumpidas en el pasado puedan reanudar su ejecución en el ecosistema actualizado sin interrumpir los procesos corporativos.
Balance calórico en escrituras masivas y optimización por almacenamiento en memoria
La selección del motor de persistencia para los puntos de control está condicionada por la intensidad y el volumen transaccional de las peticiones concurrentes. Las arquitecturas relacionales en disco ofrecen una durabilidad robusta ideal para flujos prolongados, pero introducen un cuello de botella por contención de I/O y bloqueo de tablas físicas cuando se someten a cargas masivas de ultra alta frecuencia.
Desplegar almacenes distribuidos directamente en memoria RAM resuelve este inconveniente técnico al reducir los microsegundos de lectura y escritura a niveles inferiores al milisegundo. Esta configuración de alto rendimiento, respaldada por políticas de persistencia híbrida, previene picos de retardo en la sincronización del estado de los agentes y blinda la infraestructura en plataformas con miles de ejecuciones paralelas por segundo.
Contención del tamaño de ventana mediante reductoras de contexto de conversación
El sostenimiento de flujos complejos que involucran decenas de llamadas a herramientas externas exige implementar mecanismos activos de control de tokens para prevenir el desbordamiento de la ventana del modelo. La acumulación lineal de logs de diagnóstico y mensajes intermedios satura de forma prematura los límites de entrada del LLM, disparando los costes económicos y reduciendo la capacidad de razonamiento lógico.
Para solucionar esta restricción, la arquitectura de LangGraph habilita el uso de funciones reductoras personalizadas dentro de los propios nodos. Estos componentes actúan como filtros dinámicos que podan, condensan o resumen el historial de mensajes antiguos antes de empaquetar la carga útil hacia el procesador semántico, reteniendo el volumen dentro de los umbrales de eficiencia del silicio de la Python Software Foundation.
Si quieres conocer otros artículos parecidos a Agentes de IA con LangGraph y Memoria Persistente puedes visitar la categoría Procesamiento/ IA.
Deja una respuesta
Más contenido relacionado