Cuantización de Modelos LLM a bajo nivel: Inteligencia Artificial local

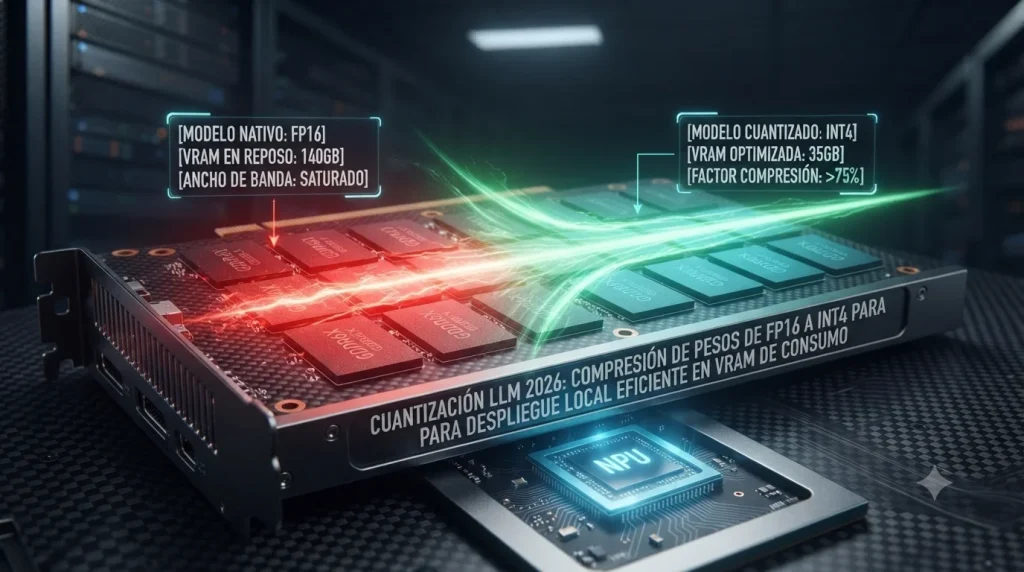
La cuantización de modelos LLM es una técnica de optimización de redes neuronales que reduce la precisión matemática con la que se almacenan los pesos del modelo, pasando de números en coma flotante de 16 o 32 bits a formatos enteros de 8, 4 o incluso 2 bits. Esta compresión drástica reduce en más de un 75% la cantidad de memoria de vídeo (VRAM) requerida y disminuye la presión sobre el ancho de banda del bus de datos, permitiendo ejecutar modelos de lenguaje masivos de nivel profesional en tarjetas gráficas de consumo general sin sufrir una degradación perceptible en sus capacidades de razonamiento.
El despliegue local de Inteligencia Artificial se ha convertido en el pilar fundamental para empresas y desarrolladores que exigen soberanía de datos, latencias ultrabajas y privacidad absoluta en la gestión de su información confidencial. Sin embargo, al intentar cargar modelos de lenguaje de última generación en servidores locales, la inmensa mayoría de las arquitecturas tropieza contra el mismo muro físico: el consumo desmedido de memoria de vídeo.
Al inaugurar esta Tanda 4 dentro de nuestra categoría Cerebro Digital, desarmaremos la ingeniería matemática que permite comprimir redes neuronales masivas. Conectando esto con nuestras publicaciones previas sobre el rendimiento de contenedores, la observabilidad de infraestructura y el aislamiento de hardware, aprenderás a dominar la cuantización de modelos LLM a bajo nivel. Descubrirás cómo reducir el consumo de VRAM de tus aceleradores gráficos mediante Formatos GGUF y AWQ, manteniendo el control operativo total de tu propia infraestructura de IA sin depender de presupuestos millonarios en la nube.
Coma flotante a enteros: La física del espacio de memoria
En su estado original de entrenamiento, un modelo de lenguaje almacena miles de millones de parámetros (pesos) en formato de coma flotante de 16 bits (FP16) o 32 bits (FP32). Cada peso representa un valor numérico continuo con una precisión decimal extrema. Para entender la magnitud del problema de memoria, almacenar un modelo de 70 mil millones de parámetros en formato FP16 requiere más de 140 gigabytes de VRAM dedicados exclusivamente a alojar la red en reposo, sin contar el espacio necesario para el contexto de la conversación.
La cuantización a bajo nivel resuelve este dilema traduciendo los valores de coma flotante de alta precisión a un espacio discreto de números enteros de menor bitaje, como enteros de 8 bits (INT8) o 4 bits (INT4). El proceso de conversión mapea un rango de números reales continuos dentro de una rejilla fija de valores enteros, acelerando la inferencia mediante la siguiente secuencia operativa:
- Fase de Entrada: El tensor de pesos en precisión flotante original FP16 se analiza por bloques para identificar el valor numérico máximo y mínimo de la capa neuronal.
- Fase de Procesamiento: Se calcula un factor de escala y un punto de offset que permiten proyectar el rango flotante continuo hacia un conjunto acotado de posiciones enteras (por ejemplo, 16 niveles posibles para cuantización de 4 bits).
- Fase de Salida (Output): Los pesos se almacenan en el nuevo formato comprimido, reduciendo el tamaño físico ocupado en la VRAM de dos bytes por peso a medio byte por peso en el caso de INT4.
Esta compresión libera espacio de almacenamiento en memoria y sustituye las complejas operaciones matemáticas en coma flotante de la GPU por operaciones con enteros, las cuales se ejecutan con mayor velocidad y menor consumo energético en los núcleos de cálculo del silicio.
AWQ vs. GGUF: Formatos de compresión de última generación
No todos los métodos de cuantización se comportan de la misma manera. En la ingeniería de inteligencia artificial moderna se destacan dos arquitecturas principales según el destino de despliegue del hardware:
- Formatos AWQ (Activation-aware Weight Quantization): Esta técnica parte de la premisa de que no todos los pesos de una red neuronal tienen la misma importancia. Al analizar la activación del modelo durante el paso de datos, AWQ identifica el uno por ciento de los pesos que resultan matemáticamente críticos para mantener la coherencia del razonamiento. Esos pesos clave se protegen y se cuantizan con menor agresividad, mientras que el noventa y nueve por ciento restante se comprime de forma severa. AWQ está optimizado exclusivamente para tarjetas gráficas (GPU) y ofrece las velocidades de inferencia más altas por segundo.
- Formatos GGUF (GPT-Generated Unified Format): Creado para el ecosistema de inferencia local de código abierto, GGUF es un formato binario autocontenido que almacena el modelo y sus metadatos en un único archivo. Su ventaja revolucionaria es el soporte para descarga de capas (layer offloading). Si la memoria de vídeo VRAM de tu tarjeta gráfica no es suficiente para albergar el modelo completo, el motor de GGUF permite dividir la red neuronal, enviando las capas sobrantes a la memoria RAM principal del servidor para ser procesadas por la CPU.
El cuello de botella en el ancho de banda y la regla de la perplejidad
Durante la fase de generación de respuestas de un modelo LLM (fase de autorregresión), el factor limitante de rendimiento no es la velocidad de cálculo bruto en TFLOPS de la GPU, sino el ancho de banda de la VRAM. Para generar un solo token de texto, la tarjeta gráfica debe leer la totalidad de los pesos del modelo alojados en la memoria y transferirlos a través del bus de datos hacia los núcleos de procesamiento.
Si un modelo pesa 140 gigabytes, la GPU debe mover 140 gigabytes de datos a través de sus canales de memoria por cada palabra generada. Al aplicar cuantización a 4 bits y reducir el tamaño de la red a 35 gigabytes, la cantidad de datos que debe viajar por el bus de la memoria se reduce a la cuarta parte. Como resultado directo, la velocidad de generación de texto se cuadruplica instantáneamente en el mismo hardware.
Sin embargo, reducir la precisión matemática introduce una métrica de degradación conocida como perplejidad. La perplejidad mide la incertidumbre del modelo al predecir el siguiente token dentro de una secuencia.
Una perplejidad más baja indica un modelo más preciso y coherente. La cuantización a 8 bits ofrece una perplejidad idéntica a la del modelo original en precisión completa. La cuantización a 4 bits incrementa la perplejidad de forma imperceptible para la mayoría de los casos de uso empresarial. No obstante, intentar comprimir modelos por debajo de los 3 bits provoca una degradación exponencial de la perplejidad, convirtiendo las respuestas del LLM en texto incoherente.
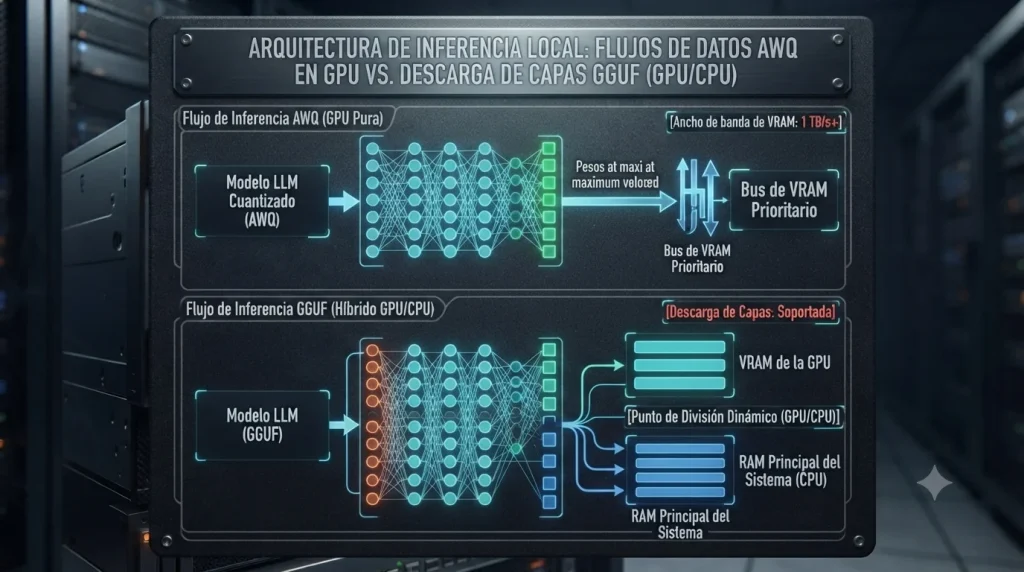
Tabla Comparativa DatoCortex
| Formato de Cuantización | Precisión por Peso (Bits) | Impacto en la Perplejidad | Hardware Ideal de Ejecución |
| Modelo Nativo (FP16) | 16 Bits (2 Bytes por peso) | Nulo (Referencia Base 100%) | Servidores empresariales con clústeres de VRAM masiva. |
| Cuantización Ligera (INT8) | 8 Bits (1 Byte por peso) | Indetectable (Menos del 0.1% de variación) | Servidores de producción local con GPUs dedicadas. |
| Cuantización Óptima (AWQ / INT4) | 4 Bits (0.5 Bytes por peso) | Mínimo (Excelente balance de razonamiento) | Tarjetas gráficas de consumo general en VRAM. |
| Cuantización Híbrida (GGUF Q4_K_M) | Variable (4 Bits con escalado por bloque) | Mínimo-Controlado | Entornos mixtos que combinan GPU, CPU y memoria RAM. |
| Cuantización Ultra-Agresiva (2 Bits) | 2 Bits (0.25 Bytes por peso) | Crítico (Aumento severo de perplejidad) | Ineficiente para tareas que exijan razonamiento lógico. |
Advertencia DatoCortex: Al descargar modelos cuantizados en formato GGUF desde repositorios públicos en este año 2026, presta especial atención a los esquemas de nombrado de variantes como Q4_K_M o Q4_K_S. La nomenclatura Q4_K_M (Medium) aplica una cuantización mixta donde las capas de atención crítica y salida de la red se mantienen con mayor precisión que las capas intermedias, ofreciendo el mejor equilibrio del mercado entre uso de VRAM y calidad de respuesta. Evita utilizar variantes Q2 o Q3 para tareas de ingeniería, programación de código o análisis financiero, ya que la pérdida de precisión matemática destruye la lógica interna del modelo.
Metodologías de compresión de modelos y optimización de memoria
Para consolidar la eficiencia de un clúster de inteligencia artificial en el borde, es indispensable comprender cómo interactúan las rutinas de compresión de pesos con el ancho de banda del hardware, la asignación dinámica del contexto en memoria y las instrucciones nativas del silicio. La optimización avanzada de redes neuronales exige un análisis metodológico profundo que eluda las métricas comerciales básicas, permitiendo identificar de qué manera el diseño del software mitiga la latencia de inferencia. A continuación, desglosaremos las especificaciones técnicas operativas para auditar, depurar y asegurar la estabilidad de los perfiles lógicos de compresión:
Divergencias de ingeniería entre algoritmos PTQ y QAT
La compresión matemática de los parámetros se divide en dos paradigmas de desarrollo según la fase de aplicación en el ciclo de vida del modelo. La cuantización post-entrenamiento (PTQ) se inyecta directamente sobre redes ya consolidadas en precisión completa, recalculando matrices mediante transformaciones algebraicas rápidas sin necesidad de procesar los conjuntos de datos masivos originales.
Por el contrario, el entrenamiento consciente de la cuantización (QAT) emula los errores de precisión de los enteros de bajo bitaje durante el propio aprendizaje del modelo. Aunque este último paradigma exige una capacidad de cómputo colosal, produce archivos optimizados con una perplejidad significativamente menor y una retención cognitiva superior en formatos restrictivos.
Jerarquía de velocidad en el transporte de datos: VRAM frente a RAM
La degradación de fotogramas o tokens por segundo al fragmentar un modelo responde a las limitaciones físicas de la autopista de memoria del host. Las arquitecturas gráficas integran memorias de alta densidad con interconexiones que alcanzan anchos de banda masivos.
Por el contrario, la memoria RAM principal del servidor opera sobre buses multicanal convencionales con tasas de transferencia sustancialmente inferiores. Al desplazar capas híbridas de un modelo autocontenido desde el acelerador hacia la placa madre, el rendimiento del hilo se desploma drásticamente, supeditado a la lentitud del canal central para suministrar los tensores al microprocesador.
El impacto escalar de la KV Cache en contextos extensos
Reducir la precisión de los pesos estáticos alivia el espacio necesario para alojar la red en reposo, pero no comprime de forma automática el búfer dinámico de atención conversacional. A medida que el prompt acumula miles de tokens de historial, la memoria dedicada a almacenar la caché de claves y valores (KV Cache) escala de manera estrictamente lineal.
En ventanas de contexto corporativas extensas, esta estructura dinámica llega a consumir un volumen de memoria de vídeo superior al del propio archivo cuantizado. Esta ineficiencia obliga a los ingenieros de sistemas a implementar técnicas de cuantización secundarias e independientes orientadas exclusivamente al búfer de atención.
Aceleración de tensores en arquitecturas embebidas ARM
La multiplicación de matrices de baja precisión encuentra una plataforma de alta eficiencia energética en las instrucciones de ejecución nativas del silicio en el borde. Las microarquitecturas de procesamiento ARM modernas integran motores de redes neuronales (NPU) y extensiones vectoriales específicamente diseñadas para acelerar operaciones aritméticas con enteros de cuatro y ocho bits.
Ejecutar modelos optimizados directamente sobre estas llamadas lógicas del procesador permite procesar tareas complejas de automatización con una latencia mínima, prescindiendo por completo del consumo calórico y los costes de integración de tarjetas gráficas discretas dedicadas.
Si quieres conocer otros artículos parecidos a Cuantización de Modelos LLM a bajo nivel: Inteligencia Artificial local puedes visitar la categoría Procesamiento/ IA.
Deja una respuesta
Más contenido relacionado