La gran mentira de los LLMs locales en portátiles: Por qué el silicio comercial estrangula la IA profunda y destruye tu hardware

- La física del silicio: La tiranía del ancho de banda de memoria
- Tabla Comparativa DatoCortex
- El sacrificio de la cuantización y la pérdida de la matriz lógica
- Umbrales de seguridad en 16GB de RAM: El límite de los modelos 8B
- El efecto Estrangulamiento Térmico (Thermal Throttling) en la inferencia continua
- Degradación estructural y estrés calórico en arquitecturas portátiles
- Desacoplamiento de cómputo: Alternativas corporativas con Privacidad Blindada
Ejecutar un modelo de lenguaje de gran escala (LLM) de arquitectura pesada, como los modelos de 70B (70 mil millones de parámetros), de forma nativa, local y fluida en un ordenador portátil de consumo es una imposibilidad técnica debido a las severas limitaciones físicas del ancho de banda del bus de memoria y la capacidad neta de la VRAM. Aunque las herramientas de compresión modernas como la cuantización (INT4 - INT8) logran reducir el peso en disco para que el modelo se aloje dentro del ecosistema de memoria física disponible, la velocidad de procesamiento real medida en tokens por segundo (t / s) se degrada hasta niveles inusables. Esto obliga al sistema operativo a paginar datos de forma masiva en el almacenamiento secundario, disparando el consumo energético y elevando las temperaturas de los componentes críticos por encima de los umbrales de seguridad, provocando un estrangulamiento térmico destructivo.
El auge de la inteligencia artificial de código abierto ha democratizado el acceso a herramientas que antes estaban confinadas a los grandes centros de datos de Silicon Valley. La promesa de la soberanía absoluta de los datos, la privacidad total frente a los servidores corporativos y la eliminación de los costes recurrentes de las suscripciones a las API de terceros ha encendido el entusiasmo de miles de desarrolladores, ingenieros y creadores de contenido. Todos quieren su propio cerebro digital funcionando de forma local en su portátil de confianza, operando de manera totalmente independiente y desconectada de la red.
Sin embargo, el marketing agresivo del año 2026 en torno a los llamados "AI PCs", las unidades de procesamiento neural (NPU) integradas en el silicio de consumo y las promesas ambiguas de la memoria unificada nos han hecho perder de vista las leyes fundamentales de la física computacional y la arquitectura de ordenadores.
Al catalogar esta auditoría técnica dentro de nuestra sección de Cerebro Digital, no podemos dejarnos llevar por el optimismo comercial; nuestro deber es desarmar el discurso corporativo analizando las matemáticas y la ingeniería reales. Conectando esto con nuestras auditorías previas sobre la latencia de las memorias de acceso aleatorio, la ineficiencia crónica de la disipación térmica en chasis ultradelgados de aluminio o el estrés calórico letal que sufren las celdas de polímero de litio en las baterías modernas, la conclusión científica es implacable: forzar la inferencia local de modelos de alta densidad en ordenadores portátiles comunes es una mentira comercial que pone en riesgo la integridad física de tu hardware.
La física del silicio: La tiranía del ancho de banda de memoria
Para entender por qué un modelo masivo de 70 mil millones de parámetros de última generación colapsa la arquitectura de un ordenador portátil estándar, es necesario sumergirse en los procesos lógicos que ocurren a nivel de registro en el silicio durante cada ciclo de inferencia. Cuando un usuario introduce un texto de petición (prompt), el software no realiza un cálculo estático. Cada palabra, carácter o fragmento semántico que genera el modelo (denominado técnicamente token) requiere que la unidad de procesamiento (sea la CPU o la GPU) lea la totalidad de los pesos del modelo de forma secuencial.
Si estás ejecutando un modelo cuyos parámetros pesan, por ejemplo, 35 GB tras la compresión, el sistema de memoria debe ser capaz de transferir esos 35 GB exactos hacia los núcleos de procesamiento para poder calcular un único e individual token. Si deseas una velocidad de lectura fluida de al menos 10 tokens por segundo, tu subsistema de memoria debe tener la capacidad física de mover 350 GB de datos cada segundo de forma constante (35 GB x 10 tokens/s= 350 GB/s).
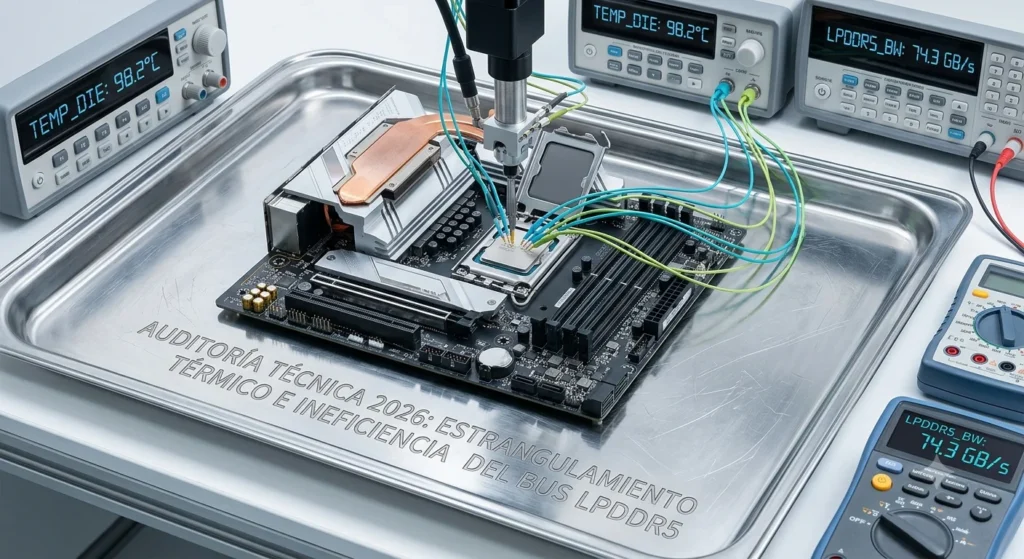
Un portátil comercial promedio equipado con memoria RAM DDR5 convencional en configuración de doble canal ofrece, en el mejor de los escenarios teóricos, un ancho de banda que oscila entre los 60 GB/s y los 90 GB/s. Al dividir matemáticamente este ancho de banda real por el peso del modelo, nos encontramos con velocidades de inferencia inferiores a un token por segundo, una métrica ridículamente inusable para cualquier entorno profesional. Cuando la memoria de video dedicada de la tarjeta gráfica (VRAM) se agota por el colosal volumen del modelo, el sistema operativo activa los mecanismos de memoria virtual de intercambio (swap), trasladando la carga de datos hacia las líneas PCIe del disco de almacenamiento sólido (SSD). El resultado es catastrófico: una caída vertical del rendimiento y una congelación total de la interfaz del sistema.
Tabla Comparativa DatoCortex
| Métrica de Infraestructura y Silicio | Entorno Portátil Comercial Estándar | Estación de Trabajo Optimizada DatoCortex |
| Capacidad Típica de VRAM / Memoria | 6GB a 8GB Dedicada (Hasta 16GB Dinámica) | 24GB Dedicada VRAM (Mínimo por Tarjeta) |
| Arquitectura de Bus y Tipo de Memoria | LPDDR5 / DDR5 (Bus de 128-bit) | GDDR6X / HBM3 (Bus de 384-bit o superior) |
| Ancho de Banda de Memoria Efectivo | 60 GB/s a 120 GB/s máximo | 300 GB/s a más de 1000 GB/s |
| Velocidad de Inferencia Real (Modelos 70B) | < 1.2 tokens/segundo (Inviable) | > 25 tokens/segundo (Estable y Fluido) |
| Temperatura del Die en Carga Sostenida | > 96°C (Zonas críticas / Throttling) | Flujo Térmico Controlado Activo (< 72°C) |
| Impacto en Componentes Adyacentes | Estrés térmico severo y degradación de batería | Disipación por cámara de vapor dedicada |
El sacrificio de la cuantización y la pérdida de la matriz lógica
Para intentar paliar esta limitación física de almacenamiento y velocidad, la comunidad de código abierto confía masivamente en las metodologías de cuantización. Este proceso matemático consiste en alterar y reducir drásticamente la precisión de los pesos flotantes con los que se entrenó originalmente la red neuronal, los cuales suelen estar expresados en precisión media de dieciséis bits (FP16). Al mapear estos valores numéricos de alta precisión y comprimirlos hacia formatos de números enteros mucho más compactos, como representaciones de ocho bits (INT8) o incluso de cuatro bits (INT4), se consigue que un modelo gigante reduzca su tamaño en gigabytes de manera drástica.
Sin embargo, esta reducción no es gratuita. La compresión matemática violenta altera la topología geométrica de los vectores dentro del espacio latente del modelo. Al pasar de una precisión de alta fidelidad a una discretización tosca, la capacidad del modelo para discernir sutiles matices lógicos, interpretar instrucciones complejas de codificación o mantener la coherencia en hilos de conversación largos se degrada sustancialmente. Un modelo de 70 mil millones de parámetros comprimido a la fuerza mediante cuantizaciones ultraagresivas de INT4 para que pueda entrar con calzador en la RAM compartida de un portátil de consumo suele arrojar peores respuestas, un mayor índice de alucinaciones y un razonamiento significativamente más errático que un modelo nativo de menor escala (como una arquitectura de 8B o 14B parámetros) que se ejecute sin pérdidas geométricas en sus pesos de precisión estándar.
Umbrales de seguridad en 16GB de RAM: El límite de los modelos 8B
Para los desarrolladores que operan con configuraciones estándar de 16 GB de memoria RAM compartida, el margen de maniobra técnica es sumamente estrecho. El límite de seguridad para evitar el colapso del sistema operativo son los modelos de 7B u 8B parámetros bajo esquemas de compresión GGUF.
Al aplicar formatos estandarizados por la comunidad en herramientas como llama.cpp (específicamente Q4_K_M o Q5_K_M), la huella del modelo en memoria oscila estrictamente entre los 4.5 GB y 6 GB. Este dimensionamiento no es caprichoso: deja el espacio suficiente para alojar el mapa de contexto del usuario (Context Window), retener los hilos de ejecución activos del ecosistema del sistema operativo y prevenir que el planificador de memoria active la paginación (swap) hacia el almacenamiento NVMe secundario, un escenario que degrada instantáneamente la velocidad a menos de un token por segundo.
El efecto Estrangulamiento Térmico (Thermal Throttling) en la inferencia continua
Un comportamiento crítico reportado por ingenieros al ejecutar tareas de inferencia local es la degradación vertical del rendimiento tras escasos minutos de procesamiento fluido. Este fenómeno no responde a un fallo de software, sino a la activación del thermal throttling a nivel de silicio.
Durante la ejecución de prompts complejos, tanto las unidades de ejecución de la GPU como las matrices tensoriales de los procesadores modernos operan a su máxima capacidad térmica de forma ininterrumpida. Dado que la tendencia de diseño industrial prioriza chasis de aluminio ultradelgados por encima de disipadores volumétricos de cobre o sistemas de ventilación forzada eficientes, el flujo de aire es incapaz de evacuar el calor residual. Al alcanzar el umbral crítico de los 95°C a 100°C en el núcleo (die), el firmware del procesador reduce drásticamente las frecuencias de reloj para evitar su propia destrucción, penalizando de forma inmediata los tiempos de respuesta.
Degradación estructural y estrés calórico en arquitecturas portátiles
Dejar un equipo portátil ejecutando tareas automatizadas de inferencia o ajuste fino (fine-tuning) durante bloques horarios prolongados induce daños mecánicos irreversibles a mediano plazo. Los chasis compactos actúan como retenedores de calor por conducción pasiva. Esta acumulación térmica constante se transfiere de forma directa hacia las celdas de las baterías de polímero de litio dispuestas bajo la placa base, acelerando la degradación de sus compuestos químicos y precipitando fallos de hinchazón física (swelling).
Paralelamente, los ciclos severos de calentamiento y enfriamiento acelerado fatigan estructuralmente las micro-soldaduras de aleación de estaño tipo BGA (Ball Grid Array) que fijan el procesador y los módulos de memoria unificada a la placa de circuito impreso, incrementando la tasa de fallos por soldaduras frías o desconexión física de pines de datos.
Desacoplamiento de cómputo: Alternativas corporativas con Privacidad Blindada
Cuando los requisitos de cumplimiento de una organización exigen la protección absoluta de datos sensibles y secretos comerciales, forzar el hardware local del usuario final es una mala decisión arquitectónica. El protocolo de ingeniería correcto dicta la separación total de la capa de cómputo.
Para empresas con infraestructura propia, la solución óptima es el despliegue de una estación de trabajo centralizada en formato torre, equipada con múltiples GPU discretas montadas en configuraciones de bus térmico abierto para garantizar la disipación masiva de calor. Para entornos distribuidos o híbridos, la alternativa eficiente consiste en la orquestación de instancias dedicadas en nubes empresariales que implementen de manera contractual políticas estrictas de Retención Cero de Datos (Zero-Data Retention) y cifrado en tránsito de los parámetros de consulta, garantizando el aislamiento lógico completo de la información frente a los conjuntos de datos públicos de entrenamiento de terceros.
Si quieres conocer otros artículos parecidos a La gran mentira de los LLMs locales en portátiles: Por qué el silicio comercial estrangula la IA profunda y destruye tu hardware puedes visitar la categoría Procesamiento/ IA.
Deja una respuesta
Más contenido relacionado