Servidores de medios con Jellyfin/Plex: Transcodificación por hardware

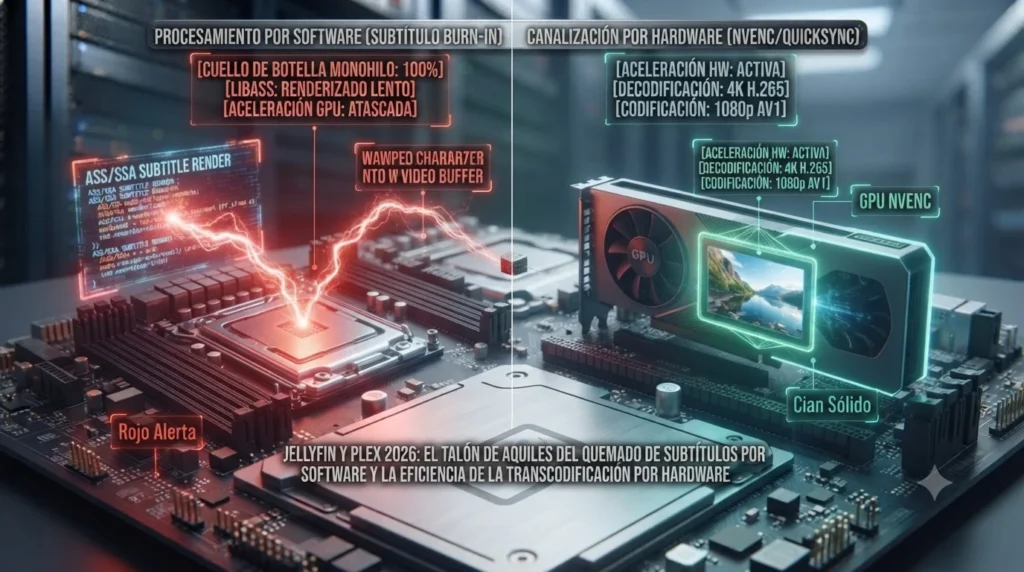
La transcodificación por hardware en servidores multimedia como Jellyfin y Plex es el proceso técnico que delega la decodificación y codificación de vídeo en tiempo real a bloques de silicio dedicados de la GPU, transformando archivos pesados en flujos adaptados a cualquier pantalla sin triturar el procesador central. Esta tecnología es indispensable porque los formatos modernos de ultra alta definición y los códecs de compresión avanzados saturan por completo las capacidades de cómputo de las CPUs tradicionales, provocando congelamientos constantes y almacenamiento en búfer si la reproducción no se realiza de forma nativa.
El verdadero cuello de botella se manifiesta debido a la trampa del quemado de subtítulos vectoriales o de mapa de bits. Cuando un dispositivo cliente no puede interpretar estos elementos, el servidor se ve obligado a desviar el flujo de imagen desde el silicio de la GPU hacia la CPU principal, incrustando los caracteres cuadro por cuadro mediante librerías monohilo que colapsan el rendimiento del sistema completo de forma instantánea.
Para solucionar de raíz esta ineficiencia estructural, la arquitectura del software libre bajo entornos Linux nos permite mapear las interfaces del controlador de renderizado directo y las bibliotecas CUDA hacia contenedores aislados de Docker. A través de esta integración perimetral, es posible habilitar la aceleración por hardware fija de Intel QuickSync Portal, enrutar los archivos temporales de caché hacia discos virtuales en memoria RAM volátil mediante montajes tmpfs y forzar el uso de reproductores de cliente dedicados. Implementar este despliegue avanzado erradica por completo la fricción de lectura y escritura en discos sólidos, neutraliza los picos de latencia causados por navegadores web incompatibles y garantiza una tasa de fotogramas fluida en la red local.
Canalización por Hardware: Integrando /dev/dri y NVENC en Docker
La transcodificación convencional por software utiliza la CPU principal del servidor para decodificar un archivo comprimido de vídeo y volver a codificarlo en un formato compatible con el dispositivo cliente. Este proceso es extremadamente ineficiente y consume decenas de hilos de cómputo.
Para solventar esta limitación, las arquitecturas modernas integran bloques de silicio con función fija (Fixed-Function Hardware Acceleration):
- Intel QuickSync Video (QSV / VAAPI): Utiliza los núcleos de cómputo gráfico integrados en las CPUs de Intel, ofreciendo una eficiencia energética masiva y un rendimiento de decodificación/codificación paralelo de baja latencia.
- NVIDIA NVENC/NVDEC: Emplea los chips de procesado de vídeo independientes montados en las tarjetas gráficas NVIDIA, liberando por completo a la CPU de las tareas de codificación de imagen.
Para habilitar esta aceleración dentro de contenedores Docker, es necesario exponer los dispositivos del sistema operativo anfitrión hacia el contenedor. En el caso de GPUs integradas Intel o AMD, se mapea la interfaz del controlador de renderizado mediante la directiva devices: /dev/dri:/dev/dri. En el caso de NVIDIA, se utiliza el paquete nvidia-container-toolkit junto con la variable de entorno NVIDIA_VISIBLE_DEVICES=all.
La trampa de los subtítulos quemados (Subtitle Burning)
Incluso con una GPU configurada correctamente y capaz de transcodificar decenas de flujos 4K de forma simultánea, el servidor puede colapsar repentinamente por culpa de los subtítulos.
Existen tres tipos principales de subtítulos en el ámbito multimedia:
- Subtítulos Planos (SRT, VTT): Archivos de texto simple con marcas de tiempo. El dispositivo cliente los descarga como un archivo de texto ligero y los dibuja por encima del vídeo en tiempo real sin requerir esfuerzo del servidor.
- Subtítulos de Mapa de Bits (PGS, VOBSUB): Utilizados en discos Blu-ray, consisten en imágenes transparentes superpuestas sobre el vídeo.
- Subtítulos Vectoriales Avanzados (ASS / SSA): Incluyen posiciones dinámicas, tipografías personalizadas, colores, animaciones y efectos gráficos vectoriales complejos.
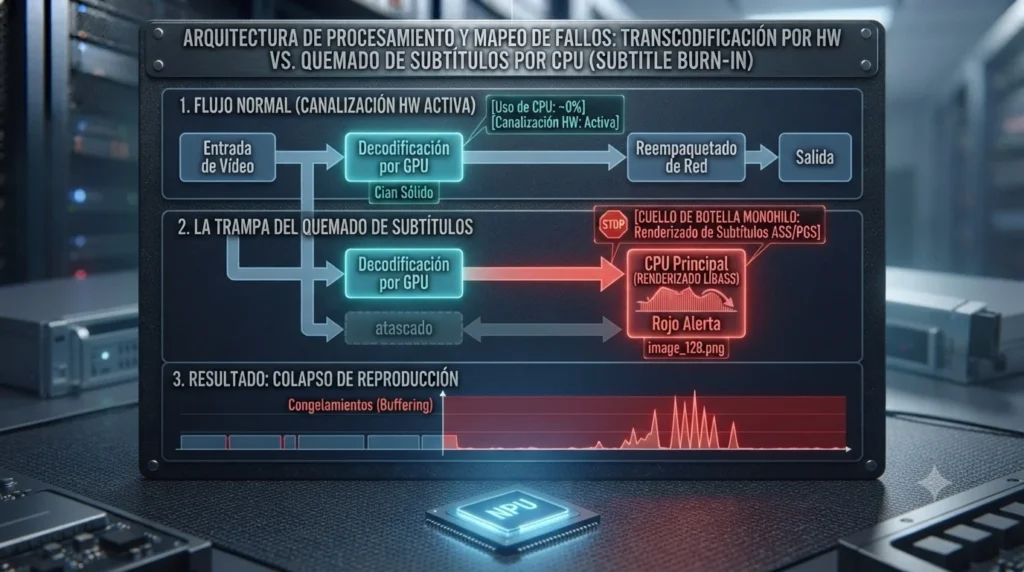
Cuando un cliente de reproducción (como una aplicación nativa de Smart TV o un navegador web) no cuenta con el motor de renderizado gráfico para interpretar subtítulos vectoriales ASS/SSA o imágenes PGS, le informa al servidor que no puede procesarlos. Para poder mostrar el texto en pantalla, el servidor de medios ejecuta el quemado de subtítulos (subtitle burn-in):
- Fase de Entrada: La GPU decodifica el marco de vídeo comprimido.
- Fase de Procesamiento: El flujo de imagen descompuesto es enviado de regreso a la CPU principal del servidor. A través de librerías monohilo como
libass, la CPU dibuja físicamente los caracteres del subtítulo sobre la matriz de píxeles del cuadro de vídeo. - Fase de Salida (Output): El cuadro con el texto incrustado vuelve a enviarse a la GPU para ser codificado de nuevo.
Debido a que la renderización de fuentes y gráficos mediante libass opera en un único hilo de procesamiento por software, la CPU del servidor se satura al 100%, la aceleración de la GPU queda atascada esperando los fotogramas procesados por la CPU y la reproducción sufre congelamientos continuos.
Optimización de caché de transcodificación mediante RAM Disk (tmpfs)
Por defecto, cuando Plex o Jellyfin transcodifican un vídeo, escriben continuamente pequeños segmentos de archivo (formato HLS / TS) en el almacenamiento del servidor para enviarlos progresivamente al cliente. Si la carpeta de temporales está ubicada en un disco SSD convencional, las escrituras masivas sostenidas (que pueden alcanzar cientos de gigabytes diarios) degradan drásticamente la vida útil del almacenamiento (TBW - Terabytes Written).
La solución técnica óptima es redirigir el directorio de transcodificación hacia un sistema de archivos en memoria RAM volátil mediante tmpfs.
Al configurar un montaje tmpfs dedicado para la carpeta de transcodificación dentro del archivo docker-compose.yml, los segmentos de vídeo temporales se escriben y leen directamente sobre la memoria RAM a velocidades de bus de sistema, eliminando por completo el desgaste de los discos SSD y reduciendo a cero la latencia de I/O durante la transcodificación.
Tabla Comparativa DatoCortex
| Parámetro de Procesamiento | Reproducción Directa (Direct Play) | Transcodificación HW (QuickSync/NVENC) | Quemado de Subtítulos por CPU (Subtitle Burn) |
| Uso de CPU del Servidor | Prácticamente 0% | Muy Bajo (Solo empaquetado de red) | Crítico (100% de uso en un hilo por cliente) |
| Uso de GPU / Silicio Dedicado | Inexistente | Moderado-Alto (Decodificación/Codificación) | Atascado (Esperando a que la CPU renderice el texto) |
| Desgaste de Almacenamiento | Nulo | Alto si no se usa tmpfs / Nulo con RAM Disk | Alto si no se usa tmpfs / Nulo con RAM Disk |
| Soporte de Subtítulos | Manejado íntegramente por el cliente | Manejado por el cliente o SRT pasante | Forzado por incrustación en la imagen |
| Calidad de Experiencia (QoE) | Máxima (Calidad original de origen) | Excelente (Adaptada al ancho de banda) | Deficiente (Pausas por buffering y picos de latencia) |
Advertencia DatoCortex: Al asignar un volumen
tmpfspara la carpeta de transcodificación de Jellyfin o Plex en este 2026, asegúrate de limitar estrictamente su tamaño máximo dentro del archivo de configuración (por ejemplo,tmpfs: /transcode:size=4g). Si no estableces un techo de capacidad y un cliente pausa la reproducción de un vídeo de alta tasa de bits mientras el servidor continúa transcodificando en segundo plano, el proceso llenará la memoria RAM física del servidor por completo, provocando un colapso por falta de memoria (Out of Memory / OOM Panic) que reiniciará el servidor.
Validación de silicio, gestión de subtítulos y rendimiento de clientes
Para consolidar la eficiencia de un clúster multimedia autoalojado, es indispensable comprender cómo interactúan los controladores lógicos del sistema operativo con las capacidades nativas de los reproductores y el procesamiento matemático de los espacios de color. La optimización avanzada de las tuberías de renderizado exige un análisis de ingeniería detallado que eluda las configuraciones genéricas, permitiendo identificar de qué manera el diseño del software mitiga la latencia y erradica los cuellos de botella en la CPU. A continuación, desglosaremos las especificaciones técnicas obligatorias para auditar, depurar y asegurar la estabilidad de los flujos de streaming locales:
Auditoría de telemetría y uso de motores de video integrados
Validar que la aceleración gráfica por hardware funcione correctamente dentro de una arquitectura contenedorizada exige interrogar los controladores del kernel en el anfitrión. Tras verificar la asignación correcta del grupo de renderizado en el contenedor, se debe auditar el comportamiento del chip gráfico utilizando herramientas oficiales del consorcio de semiconductores como Intel GPU Top Utility, integrada en las utilidades nativas de telemetría de Linux. Durante la ejecución de un flujo de video que demande conversión, constatar que los motores dedicados de video exhiben porcentajes de uso activos mientras la CPU retiene umbrales mínimos de carga confirma que el procesamiento se ejecuta limpiamente a nivel de silicio.
Pasaje de texto web nativo y prevención de la incrustación de imagen
La extracción automática de los flujos de texto planos incrustados originalmente en contenedores multimedia avanzados como MKV es una estrategia clave para impedir la degradación del procesador central. Al habilitar esta instrucción, el servidor intercepta el flujo de datos de texto plano, convirtiéndolo al vuelo en un estándar web nativo. Este procedimiento transmite los subtítulos de forma totalmente independiente como una pista de texto aislada, permitiendo que sea el dispositivo cliente el encargado de dibujar las letras en pantalla mediante software local, eludiendo la costosa manipulación de matrices de píxeles en el servidor.
Computación matemática de mapeo de tonos en shaders dedicados
La conversión de rango dinámico alto a rango dinámico estándar durante una solicitud de transcodificación impone demandas críticas debido a la recalibración de color requerida. Realizar este mapeo de tonos a través de hilos genéricos de la CPU degrada el rendimiento de la máquina. En arquitecturas modernas, esta conversión matemática se enruta de forma íntegra a través de las canalizaciones lógicas de la GPU empleando shaders y la API de bajo nivel Khronos OpenCL Standard, lo que faculta al silicio para adaptar la colorimetría en tiempo real sin estresar el microprocesador principal.
Mitigación de restricciones de códecs mediante reproductores basados en MPV
Los navegadores web convencionales experimentan limitaciones estrictas respecto a los licenciamientos de códecs comerciales de audio y video, careciendo además de motores para interpretar subtítulos vectoriales complejos de forma nativa. Esta insuficiencia fuerza la activación obligatoria de la transcodificación en el servidor.
Implementar clientes de escritorio dedicados soluciona esta fricción de raíz. Al integrar librerías basadas en el motor especializado MPV Media Player Project, estas aplicaciones autónomas decodifican de forma directa prácticamente cualquier formato de compresión o subtítulo existente en el mercado, forzando el modo de reproducción directa y reduciendo la carga computacional del host a cero.
Si quieres conocer otros artículos parecidos a Servidores de medios con Jellyfin/Plex: Transcodificación por hardware puedes visitar la categoría Tendencias / Seguridad.
Deja una respuesta
Más contenido relacionado