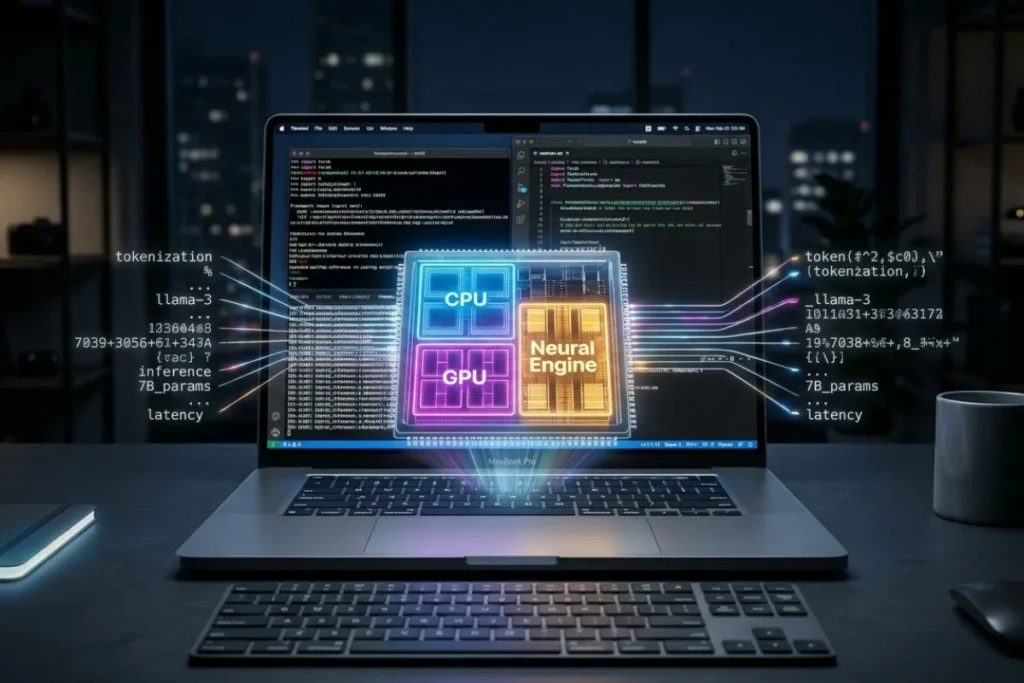
Inferencia Local de LLMs en el New MacBook Pro: Optimizando el Neural Engine y la Memoria Unificada

- El Motor Neuronal a Fondo: Arquitectura del Neural Engine
- Memoria Unificada (UMA) y el Desafío del Ancho de Banda en LLMs
- Cuantización y Pipelines de Ejecución en MLX y Core ML
- Inferencia Híbrida: Orquestando CPU, GPU y Neural Engine
- Casos de Uso Profesionales en el Ecosistema de Desarrollo
- Eficiencia por Vatio y Sostenibilidad Térmica en Cargas de IA
- Tabla Analítica de Capacidades de Cómputo de IA
El despliegue de modelos de lenguaje de gran tamaño (LLMs) y arquitecturas de Inteligencia Artificial generativa ha trasladado el centro de gravedad del cómputo desde los servidores en la nube hacia las estaciones de trabajo locales. Con la introducción del New MacBook Pro, los desarrolladores de software, ingenieros de datos y administradores de sistemas cuentan con una arquitectura de silicio diseñada específicamente para romper las limitaciones tradicionales de la inferencia on-device.
La integración de los coprocesadores de aceleración neuronal de última generación, coordinados con los núcleos de rendimiento de la CPU y la GPU, transforma este dispositivo en un nodo de cálculo de alta eficiencia. Para el ecosistema técnico, el verdadero valor de esta actualización no radica únicamente en la velocidad de procesamiento cruda, sino en la capacidad de ejecutar pipelines complejos de aprendizaje profundo en movilidad sin depender de APIs externas ni comprometer la privacidad de los conjuntos de datos.
El Motor Neuronal a Fondo: Arquitectura del Neural Engine
El pilar fundamental que sostiene el procesamiento de Inteligencia Artificial en el New MacBook Pro es su renovado Neural Engine. Este coprocesador especializado en operaciones de tensores y matrices ha sido rediseñado a nivel de microarquitectura para maximizar la ejecución de instrucciones matemáticas de precisión reducida, como FP16 e INT8, las cuales dominan las redes neuronales modernas.
   [ Datos del Modelo ] ---> [ Unidad de Cómputo Matricial ]
                                       |
  [ Memoria Unificada ] <---> [ Caché de Tensores Dedicada ] ---> [ Resultados de Inferencia ]
                                       |
                             [ Motor de Compresión ]
A diferencia de las unidades de procesamiento gráfico tradicionales (GPUs), que distribuyen su potencia en sombreadores y renderizado de geometría, el Neural Engine enfoca la totalidad de sus transistores en acelerar las multiplicaciones y acumulaciones de matrices (operaciones MAC). La nueva iteración del motor añade una caché de tensores dedicada que reduce de forma drástica la necesidad de consultar el bus de memoria principal durante los bucles de retroalimentación de la inferencia.
Esta optimización permite que herramientas avanzadas de desarrollo técnico ejecuten capas densas de atención de transformadores de manera nativa, elevando la tasa de procesamiento de tokens por segundo al tiempo que mitigan el consumo de energía en el silicio, un factor crítico para entornos profesionales analizados detalladamente en la documentación de Apple Developer Information.
Memoria Unificada (UMA) y el Desafío del Ancho de Banda en LLMs
En la computación de bajo nivel enfocada en Inteligencia Artificial, la velocidad de ejecución de un modelo de lenguaje está limitada casi en su totalidad por el ancho de banda de la memoria, un cuello de botella físico conocido en la ingeniería de sistemas como Memory Bandwidth Bound. Debido a que cada token generado por un LLM requiere que la totalidad de los pesos (weights) del modelo se carguen en la memoria intermedia, las arquitecturas de PC tradicionales sufren penalizaciones severas al transferir datos a través del bus PCIe entre la memoria RAM del sistema y la VRAM de la tarjeta gráfica dedicada.
La arquitectura de Memoria Unificada (UMA) del New MacBook Pro anula este retraso estructural al fusionar los chips de memoria de alta velocidad directamente sobre el sustrato del procesador central. Al compartir un único direccionamiento de memoria de baja latencia, los núcleos de la CPU, la GPU y el Neural Engine leen y escriben sobre el mismo conjunto de datos sin necesidad de realizar duplicaciones ni copias lentas.
En configuraciones profesionales de gran escala, este bus masivo permite alojar modelos de parámetros densos (como Llama-3 o Mistral) en su totalidad dentro de la memoria del chip, acelerando la velocidad del direccionamiento tal como ocurre al optimizar la eficiencia física en arquitecturas de Latencia CAS en estaciones de trabajo de escritorio convencionales.
Cuantización y Pipelines de Ejecución en MLX y Core ML
Para exprimir las capacidades de hardware del New MacBook Pro sin saturar la asignación de memoria, los desarrolladores dependen de frameworks de software optimizados que interactúen de forma directa con las instrucciones del silicio. Dos entornos dominan esta capa de abstracción técnica: Core ML para la integración en aplicaciones nativas de macOS y MLX, el framework de código abierto diseñado por el equipo de investigación de IA de Apple para la computación científica.
[ Modelo FP32 Original ] ---> [ Algoritmo de Cuantización ] ---> [ Modelo INT4 / INT8 Optimizado ]
                                                                                |
                                                                                v
                                                                   [ Inferencia en MLX / Core ML ]
Estos entornos permiten la implementación de técnicas de cuantización avanzada, un proceso matemático que reduce la precisión de los pesos del modelo (por ejemplo, de punto flotante de 32 bits a enteros de 4 u 8 bits). Al aplicar cuantización a un LLM, el tamaño físico del archivo se reduce hasta en un 80%, permitiendo que un modelo que originalmente requería 40 GB de espacio se aloje en menos de 8 GB de memoria unificada.
MLX aprovecha esta reducción para saturar los canales de ejecución del Neural Engine, procesando las matrices cuantizadas mediante aceleración por hardware directa, lo que se traduce en una latencia de respuesta inicial (Time to First Token) sumamente baja y un flujo de generación constante que no penaliza la temperatura del encapsulado.
Inferencia Híbrida: Orquestando CPU, GPU y Neural Engine
Uno de los hitos más complejos de la ingeniería de software en el New MacBook Pro es la orquestación dinámica de las cargas de trabajo de IA a través de la inferencia híbrida. El sistema operativo macOS distribuye dinámicamente las tareas de cálculo matemático basándose en la topología de la red neuronal y los recursos disponibles en cada milímetro de silicio:
- Neural Engine (Carga Primaria): Procesa de forma prioritaria las capas convolucionales, los bloques de atención lineal y los modelos de visión por computadora que se ajusten a sus patrones de optimización de tensores de baja precisión.
- Unidad de Procesamiento Gráfico (GPU): Entra en acción cuando el modelo requiere operaciones personalizadas que escapan al conjunto de instrucciones fijas del Neural Engine, o cuando se ejecutan pipelines de renderizado generativo masivo como difusión estable (Stable Diffusion), donde el paralelismo gráfico masivo es mandatorio.
- Unidad Central de Procesamiento (CPU): Gestiona la lógica de control superior, la tokenización del texto de entrada, el formateo de los datos de salida y los algoritmos de muestreo de probabilidad (como Top-P o Temperature), garantizando que las unidades aceleradoras se mantengan enfocadas exclusivamente en el cálculo matricial puro.
Esta división del trabajo emula las infraestructuras de orquestación utilizadas en centros de datos modernos de gran escala. De hecho, los desarrolladores que buscan maximizar el rendimiento de modelos distribuidos aplican arquitecturas similares a las descritas en guías de automatización avanzadas como el despliegue de Agentes de IA con LangGraph y Memoria Persistente, trasladando la lógica de agentes de servidor hacia el entorno de desarrollo local en macOS.
Casos de Uso Profesionales en el Ecosistema de Desarrollo
La viabilidad de ejecutar Inteligencia Artificial pesada de forma local transforma radicalmente las dinámicas de trabajo de múltiples sectores técnicos que anteriormente dependían de costosas instancias en la nube.
- Ingeniería de Software y Compilación Asistida
Los desarrolladores pueden ejecutar modelos de generación de código de tamaño medio (como CodeLlama u DeepSeek-Coder) en segundo plano, completamente integrados en sus entornos de desarrollo (IDEs). Al no enviar código fuente a servidores externos para obtener sugerencias de autocompletado, las empresas blindan su propiedad intelectual y mitigan los riesgos de cumplimiento normativo, manteniendo la latencia de compilación por debajo de los umbrales de detección humana.
- Científicos de Datos y Fine-Tuning de Modelos
Aunque el entrenamiento a gran escala de modelos fundacionales sigue siendo terreno exclusivo de clusters de servidores empresariales, el New MacBook Pro permite realizar procesos de ajuste fino (Fine-Tuning) mediante técnicas eficientes como LoRA (Low-Rank Adaptation). Un ingeniero puede cargar un modelo base, inyectar un conjunto de datos especializado de un nicho de negocio y ajustar los parámetros directamente en la memoria unificada del equipo portátil, validando la precisión del modelo antes de su despliegue masivo en producción.
Eficiencia por Vatio y Sostenibilidad Térmica en Cargas de IA
El verdadero triunfo de la arquitectura del New MacBook Pro en el campo de la Inteligencia Artificial no es la potencia bruta que alcanza, sino su eficiencia energética. Sostener la inferencia de un LLM en una arquitectura de hardware tradicional de PC de escritorio requiere fuentes de alimentación de cientos de vatios y sistemas de refrigeración líquida complejos para disipar el calor de las tarjetas gráficas dedicadas.
El diseño optimizado de Apple Silicon permite que el Neural Engine procese miles de millones de operaciones por segundo consumiendo apenas una fracción de la energía. Esto evita el estrangulamiento térmico (thermal throttling) bajo cargas prolongadas de inferencia, manteniendo la consistencia del rendimiento de tokens por segundo incluso cuando el equipo opera utilizando la energía de la batería, un estándar de eficiencia ampliamente estudiado por comunidades científicas globales a través de publicaciones indexadas en la IEEE Xplore Digital Library.
Tabla Analítica de Capacidades de Cómputo de IA
Para comprender el rendimiento teórico de los componentes que integran el nuevo ecosistema de procesamiento del dispositivo, el siguiente desglose clasifica las tareas óptimas para cada unidad operativa:
| Unidad de Hardware | Precisión Matemática Óptima | Tarea de IA Recomendada | Tipo de Acceso a Memoria |
|---|---|---|---|
| Neural Engine | INT8 / FP16 (Baja precisión) | Inferencia de LLMs cuantizados, Visión por Computadora | Directo a través de Caché de Tensores integrada |
| Unidad Gráfica (GPU) | FP16 / FP32 (Precisión Media) | Difusión Estable, Render Generativo, Modelos de Audio | Acceso compartido de alta velocidad en Bus UMA |
| Unidad Central (CPU) | FP32 / FP64 (Alta precisión) | Tokenización, Lógica de Muestreo, Preprocesamiento | Control de direccionamiento principal del sistema |
Este análisis técnico demuestra que el New MacBook Pro ha dejado de ser un simple ordenador personal para convertirse en una estación de trabajo de Inteligencia Artificial altamente especializada, redefiniendo las reglas de la computación local en la era del procesamiento inteligente.
Si quieres conocer otros artículos parecidos a Inferencia Local de LLMs en el New MacBook Pro: Optimizando el Neural Engine y la Memoria Unificada puedes visitar la categoría Procesamiento/ IA.
Deja una respuesta
Más contenido relacionado