Monitoreo de infraestructura con Prometheus y Grafana sin saturar tu CPU

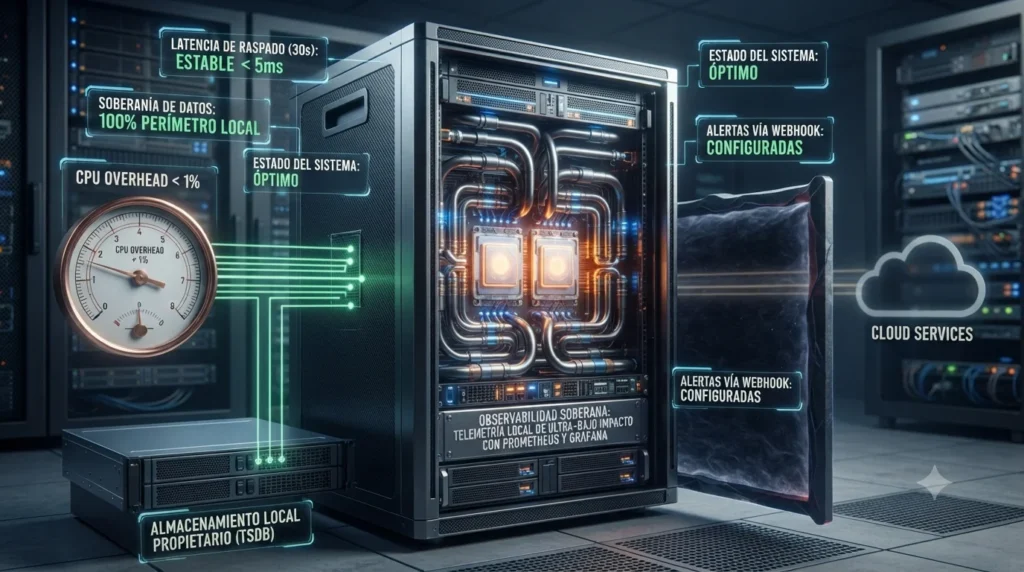
Implementar un sistema de monitoreo de infraestructura con Prometheus y Grafana de alta visibilidad exige optimizar el intervalo de recolección de métricas (scraping interval) y configurar los exportadores nativos a bajo nivel para impedir el sobreconsumo de ciclos de procesamiento. Almacenar los datos de telemetría localmente en una base de datos de series temporales (TSDB) optimizada permite auditar el rendimiento de servidores y redes en tiempo real sin saturar la CPU ni depender de costosos servicios de terceros, consolidando una infraestructura de observabilidad soberana, privada y eficiente.
La observabilidad y el análisis de telemetría en tiempo real se han convertido en las herramientas de defensa y optimización más críticas para cualquier administrador de sistemas o arquitecto de infraestructura. Conocer la temperatura exacta de los nucleos de silicio, la saturación de los canales de red y el comportamiento del almacenamiento permite adelantarse a fallos mecánicos e intrusiones de seguridad antes de que provoquen una caída del servicio. Sin embargo, al desplegar herramientas de medición, muchos ingenieros cometen el error de configurar sistemas que consumen más recursos de hardware que las propias aplicaciones que intentan supervisar.
En este apartado analizaremos las mejores prácticas de observabilidad perimetral. Conectando esto con nuestras publicaciones previas sobre la seguridad en redes locales, la optimización de servidores de cómputo y el aislamiento de contenedores, aprenderás a dominar el monitoreo de infraestructura con Prometheus y Grafana. Descubrirás cómo configurar exportadores de hardware con un impacto de procesamiento prácticamente imperceptible, manteniendo el control absoluto y la soberanía total de los datos de telemetría dentro de las fronteras de tu propia red local.
El protocolo de raspado y la mitigación del impacto en la CPU
Prometheus opera bajo un paradigma de diseño fundamentado en el modelo de extracción por tracción o pull protocol, diferenciándose radicalmente de los sistemas tradicionales que empujan telemetría constantemente hacia un servidor central. En esta arquitectura, las máquinas supervisadas ejecutan demonios ligeros denominados exportadores. Estos agentes exponen un endpoint HTTP plano en un puerto específico de la red local que contiene las lecturas crudas de los componentes físicos del entorno.
El servidor central realiza peticiones de lectura periódicas a estos puertos en un proceso denominado raspado o scraping, donde el tiempo transcurrido entre consultas define el scraping interval. Configurar este parámetro a intervalos absurdamente bajos es la causa principal de la degradación del rendimiento del procesador de control. Cuando esta frecuencia se satura con solicitudes continuas, el exportador activa la siguiente secuencia de procesamiento vertical en la máquina objetivo:
- Fase de Entrada: El demonio local recibe la solicitud de extracción entrante desde el servidor central.
- Fase de Procesamiento: El agente realiza llamadas al sistema operativo de bajo nivel para leer los archivos virtuales, recolectando el uso de memoria, hilos y discos.
- Fase de Salida (Output): Los datos se formatean en texto plano estructurado y se transmiten por la red, liberando el hilo del núcleo para evitar latencias.
Para optimizar el rendimiento en producción en este año 2026, la recomendación de ingeniería es establecer un equilibrio en la frecuencia de recolección. Para servidores estándar o infraestructura de desarrollo, un intervalo de entre 15 y 30 segundos es el rango idóneo. Configurar intervalos amplios mantiene el silicio en reposo, reduciendo el overhead de procesamiento a menos del uno por ciento de la capacidad total del hardware y proporcionando una resolución temporal perfecta para detectar anomalías o patrones de ataque.
Optimización de la TSDB local y eficiencia en la persistencia de datos
Una vez que el sistema extrae las métricas, los datos se confinan localmente en su propia base de datos de series temporales o TSDB. A diferencia de los motores relacionales tradicionales, esta estructura está optimizada exclusivamente para indexar flujos secuenciales donde la variable principal es el tiempo y los valores fluctúan constantemente. Para garantizar consultas veloces y proteger el espacio en disco, el motor implementa una estrategia de almacenamiento por bloques de memoria.
Por defecto, el software vuelca las métricas entrantes en un bloque volátil denominado Head Block, respaldado por un registro de escritura previa o WAL para prevenir pérdidas ante caídas de tensión eléctrica. Cada dos horas, el sistema congela este segmento y lo escribe en el disco duro en forma de un bloque persistente, sellado e inmutable.
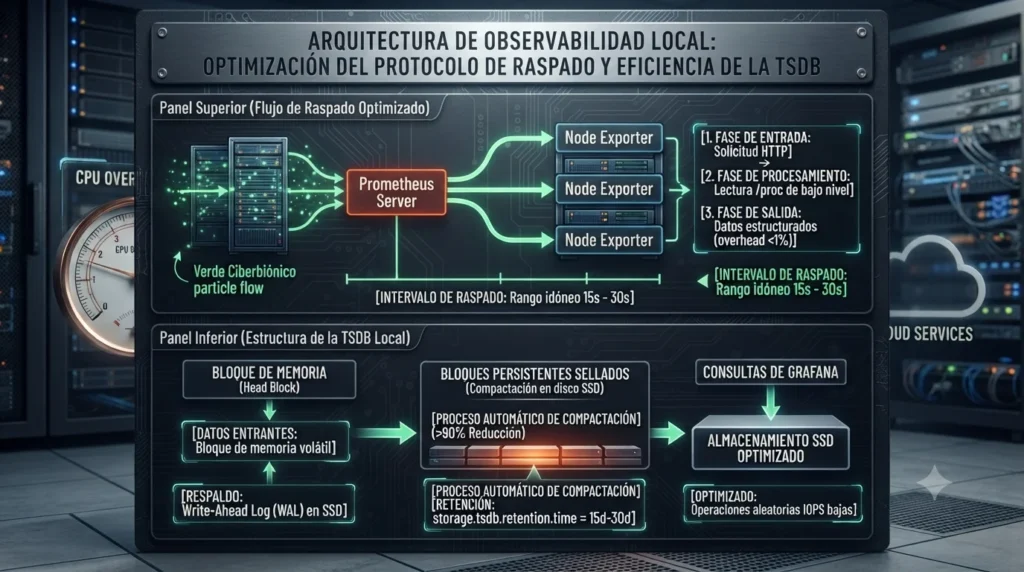
Para optimizar esta topología de almacenamiento, el administrador debe ajustar tres parámetros críticos directamente en los argumentos de ejecución:
- Retención cronológica (storage.tsdb.retention.time): Define el ciclo de vida de las métricas antes de su purga automática. Un rango de entre 15 y 30 días basta para identificar tendencias sin saturar el almacenamiento.
- Retención volumétrica (storage.tsdb.retention.size): Actúa como un disyuntor de seguridad física. Especificar un límite máximo (como 50 gigabytes) obliga al motor a borrar registros antiguos si se roza el umbral, impidiendo fallos por disco lleno.
- Compactación de bloques: Ejecuta tareas en segundo plano que consolidan múltiples bloques de dos horas en segmentos mayores que cubren días enteros. En este proceso, el algoritmo elimina duplicados y comprime el índice, liberando hasta un noventa por ciento de espacio.
Esta configuración avanzada asegura la longevidad del hardware de monitoreo, manteniendo la latencia de lectura en mínimos estructurales.
Tabla Comparativa DatoCortex
| Métrica Operativa | Plataformas SaaS en la Nube | Pila Local Prometheus + Grafana |
| Soberanía y Privacidad de Datos | Nula (Toda la topología y datos de red se envían a terceros) | Absoluta (La telemetría jamás abandona el perímetro local) |
| Costo Financiero | Variable y Elevado (Tarificación por volumen de tokens/métricas extraídas) | Gratuito y Predecible (Software de código abierto bajo hardware propio) |
| Impacto en el Ancho de Banda | Continuo (Tráfico constante de subida hacia servidores externos en internet) | Interno (Consumo de red local exclusivo, sin impacto en el canal de internet) |
| Resiliencia ante Cortes de Internet | Inoperable (Si se cae la conexión externa, se pierde el monitoreo por completo) | Total (Sigue recolectando y alertando de forma interna sin interrupciones) |
Configuración de alertas mediante Webhooks locales: Seguridad sellada
Un sistema de monitororeo carece de utilidad práctica si el administrador no recibe notificaciones inmediatas ante incidentes críticos (como un incremento térmico peligroso en la GPU o la caída de un contenedor Docker). Para procesar estas alertas de forma nativa sin depender de servicios externos en la nube, Prometheus se apoya en el componente Alertmanager.
Alertmanager recibe los eventos generados por Prometheus cuando una métrica cruza un umbral de peligro establecido por el usuario. En lugar de reenviar estas alertas a través de servidores de correo electrónico externos o APIs propietarias que requieran salida a internet, la arquitectura de seguridad avanzada exige la implementación de Webhooks locales.
Un Webhook local es una solicitud HTTP POST automatizada que el Alertmanager envía hacia un servicio de mensajería auto-alojado en tu propio servidor o red interna, como una instancia local de Matrix, Mattermost o un script automatizado. Esto permite centralizar la gestión de emergencias sin abrir puertos en el router y sin exponer la identidad de las máquinas afectadas hacia el exterior de la organización.
Advertencia DatoCortex: En este año 2026, al diseñar paneles de visualización en Grafana, evita la trampa de configurar consultas complejas con funciones de agregación excesivas que refresquen los paneles cada segundo en pantallas fijas de supervisión. Grafana ejecuta estas consultas directamente sobre la TSDB de Prometheus cada vez que el Panel se actualiza. Si mantienes una pantalla abierta realizando cálculos de medias móviles sobre millones de registros históricos de forma ininterrumpida, provocarás un cuello de botella de lecturas en el almacenamiento que elevará el uso del procesador del servidor de monitoreo al cien por cien, auto-infligiendo una denegación de servicio en tu propia infraestructura de control.
Gobernanza de series temporales y mitigación de alertas
Para consolidar la estabilidad de una infraestructura de observabilidad perimetral, es indispensable comprender cómo interactúan los demonios de recolección con las APIs del sistema operativo, las topologías de indexación en disco y los motores de enrutamiento de emergencias. La gestión avanzada de la telemetría exige un análisis riguroso que va más allá de la simple visualización de gráficos, permitiendo identificar de qué manera el diseño del software previene la degradación física del hardware de control. A continuación, desglosaremos las especificaciones técnicas operativas para auditar, depurar y asegurar la persistencia de las métricas sin comprometer la capacidad de procesamiento local:
Ventajas de los demonios nativos frente a la automatización de scripts
La recolección de telemetría a bajo nivel se ejecuta de forma óptima mediante binarios especializados que interactúan directamente con el kernel del sistema operativo. Utilizar herramientas nativas como el repositorio oficial de Prometheus Node Exporter faculta al administrador para interrogar los sistemas de archivos virtuales de Linux en microsegundos.
A diferencia de los scripts tradicionales que inicializan procesos concurrentes del sistema de forma repetitiva saturando la CPU de manera innecesaria, este demonio mantiene una estructura en memoria persistente de ejecución única. Este diseño reduce el overhead de procesamiento a valores insignificantes, garantizando una extracción limpia del estado de los componentes físicos.
Mitigación de la alta cardinalidad en el índice de series temporales
El fenómeno técnico de la saturación de etiquetas o alta cardinalidad representa una de las mayores amenazas para la estabilidad de la base de datos de series temporales (TSDB). Esta anomalía se manifiesta cuando se inyectan variables de valor infinito o mutación constante tales como marcas de tiempo detalladas o identificadores de sesión web únicos dentro de las etiquetas de una métrica.
Debido a que cada combinación única engendra una serie temporal independiente, generar millones de vectores huérfanos satura los índices de búsqueda del motor. Como consecuencia directa, se dispara el uso de la memoria RAM del servidor y se ralentiza de forma severa el renderizado de consultas analíticas.
Inhibición de alertas y consolidación en caídas de infraestructura
La gestión inteligente de eventos ante fallos masivos en la infraestructura de red exige la implementación de mecanismos deterministas de agrupación. Cuando un conmutador principal experimenta una pérdida de energía, las terminales conectadas pierden conectividad de manera simultánea, provocando una avalancha de notificaciones concurrentes.
Para contener este caos de telemetría, el componente especializado de orquestación Prometheus Alertmanager inyecta reglas estrictas de inhibición y agrupamiento. El software intercepta las alertas secundarias, suprime las notificaciones de los servidores individuales y despacha un único mensaje consolidado que aísla la causa raíz, previniendo la saturación de los canales de comunicación de emergencias.
Exigencias de operaciones aleatorias en el almacenamiento físico
A pesar de que el motor de la base de datos ejecuta la compactación de los bloques de datos de forma secuencial y eficiente, las consultas concurrentes de las reglas de alerta exigen una alta tasa de operaciones de lectura aleatoria por segundo (IOPS). Los discos duros mecánicos tradicionales son técnicamente incapaces de gestionar este nivel de estrés cuando el historial acumula semanas de registros.
Alojar los archivos de índices sobre unidades de estado sólido (SSD) garantiza latencias de lectura en el orden de los milisegundos. Esta especificación de hardware impide retrasos en la carga de paneles y evita la pérdida de muestras críticas bajo cargas masivas de trabajo corporativo
Si quieres conocer otros artículos parecidos a Monitoreo de infraestructura con Prometheus y Grafana sin saturar tu CPU puedes visitar la categoría Tutoriales.
Deja una respuesta
Más contenido relacionado