Memoria RAM en 2026: Por qué la latencia CAS importa más que los MHz en la era de la IA local

- Las matemáticas del acceso al silicio: El cálculo real en nanosegundos
- Tabla Comparativa DatoCortex
- La estructura de los modelos de IA y el acceso aleatorio masivo
- Arquitectura de bancos en DDR5 y la equivalencia real de acceso
- Metodologías de diagnóstico técnico para timings en el sistema operativo
- Topología de canales: El impacto crítico de usar 2 vs 4 módulos en IA
- Especificación equilibrada para estaciones de trabajo con IA local
En el ecosistema técnico actual, el rendimiento real de una memoria RAM DDR5 ejecutando tareas de Inteligencia Artificial local no está determinado únicamente por la frecuencia bruta medida en megahercios (MHz), sino por la latencia CAS (Column Address Strobe) y los timings primarios del módulo. Mientras que los MHz definen el ancho de banda teórico de transferencia secuencial, la latencia CAS mide el tiempo que tarda la memoria en responder a una solicitud de datos del procesador. Debido a que la inferencia de modelos de lenguaje de gran tamaño (LLM) requiere saltos de acceso aleatorio masivos y constantes para consultar matrices de pesos, un módulo con alta frecuencia pero latencias descompensadas introduce micro-retrasos críticos que estrangulan la velocidad de ejecución.
La evolución del almacenamiento temporal nos ha acostumbrado a una métrica de marketing muy lineal: a mayor número de megahercios, mayor velocidad general del sistema. Con la maduración de la arquitectura de memoria actual, los fabricantes compiten por alcanzar frecuencias astronómicas, rompiendo barreras comerciales con perfiles de overclocking automatizados que prometen tasas de transferencia masivas. Esta velocidad secuencial es excelente para mover archivos gigantescos o renderizar vídeo en resoluciones extremas, donde los datos fluyen en una sola dirección predecible.
Sin embargo, el paradigma de la computación ha cambiado drásticamente con la integración de flujos de IA ejecutados de forma local en estaciones de trabajo de vanguardia. De acuerdo con los estándares técnicos publicados por el consorcio de estandarización de semiconductores JEDEC, el acceso aleatorio masivo a las celdas de memoria DRAM penaliza severamente los retardos en los ciclos de bus. Al evaluar cómo interactúa el silicio de la memoria con los núcleos de cálculo tensorial, demostraremos que el verdadero secreto de la velocidad no radica en qué tan rápido viajan los datos a través del bus, sino en cuántos nanosegundos tarda el controlador en localizar la dirección de memoria exacta que el algoritmo requiere procesar.
Las matemáticas del acceso al silicio: El cálculo real en nanosegundos
Para entender por qué la Inteligencia Artificial local penaliza las latencias altas, debemos comprender cómo se comunica el procesador con la memoria RAM. La frecuencia en MHz determina cuántos ciclos de reloj realiza la memoria por segundo, mientras que los timings (expresados en números como CL30-36-36-76) definen la cantidad de ciclos de reloj que el hardware debe esperar para completar una operación lógica específica. La latencia CAS (CL) es el primer valor y representa el retraso entre la orden de lectura del procesador y la entrega del primer bit de datos.
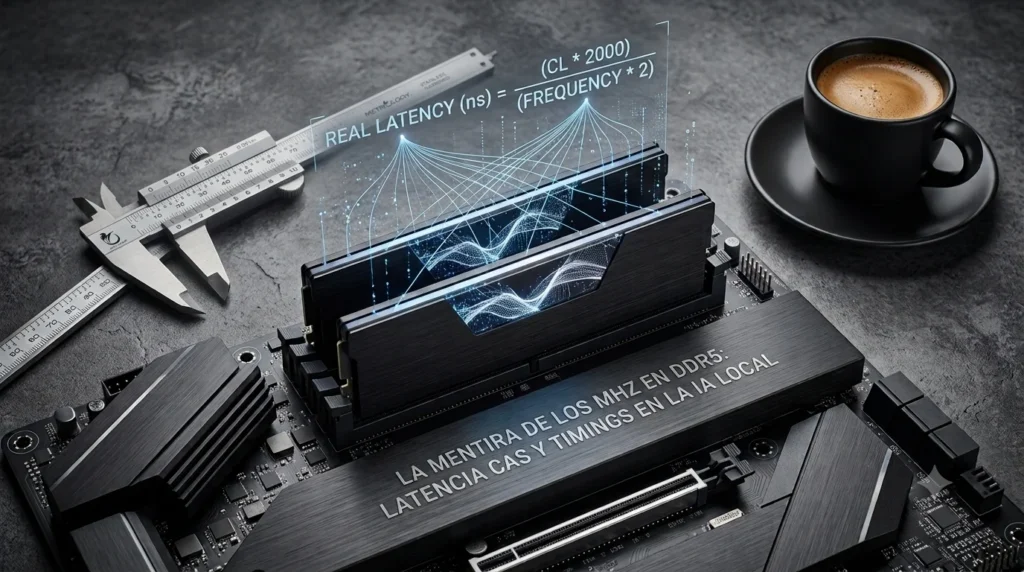
Para hallar el tiempo de respuesta absoluto medido en nanosegundos (ns), no podemos mirar los MHz de forma aislada. La fórmula técnica para calcular la latencia real de acceso es:

Si aplicamos esta ecuación matemática a dos escenarios comerciales comunes, la realidad del hardware queda al descubierto. Un módulo de memoria DDR5 genérico configurado a 7200 MHz con una latencia CL40 ofrece un tiempo de acceso real de 11.11 nanosegundos. En contraste, un módulo optimizado de 6000 MHz pero con una latencia ajustada de CL30 responde en exactamente 10.00 nanosegundos. A pesar de tener menos MHz nominales, el segundo módulo localiza la información un 10% más rápido, permitiendo que la unidad de procesamiento ejecute la matriz del modelo sin perder ciclos de reloj en tiempos de espera muertos.

Tabla Comparativa DatoCortex
| Especificación Técnica del Módulo | Configuración Comercial Comercial (Hype de MHz) | Configuración de Núcleo Optimizada Cortex |
| Frecuencia Nominal del Bus | 7200 MHz (Overclock Extremo) | 6000 MHz (Punto de Equilibrio Dulce) |
| Latencia CAS Primaria (CL) | CL40 | CL30 |
| Tiempo de Acceso Real | 11.11 nanosegundos | 10.00 nanosegundos (Más Rápido) |
| Estabilidad del Controlador (IMC) | Inestable (Requiere voltajes altos en VDD/VDDQ) | Alta Estabilidad nativa a 1.35V |
| Rendimiento en Inferencia Local | Pérdida de tokens/s por latencia aleatoria | Máximo rendimiento sostenido en LLMs |
| Generación de Calor en Módulo | Elevada (Requiere disipación activa en chasis) | Moderada (Disipación pasiva eficiente) |
La estructura de los modelos de IA y el acceso aleatorio masivo
A diferencia de un videojuego tradicional, donde los elementos del mapa se cargan de forma secuencial y predecible en la memoria, un modelo de lenguaje de Inteligencia Artificial opera bajo un principio probabilístico no lineal. Durante la inferencia, para generar una sola palabra, el software debe consultar miles de nodos interconectados dentro del espacio latente de la red neuronal. Esto se traduce en millones de solicitudes de lectura dispersas a lo largo de toda la superficie física de los chips de memoria de acceso aleatorio.
Cuando la memoria RAM trabaja bajo este nivel de estrés aleatorio masivo, la velocidad secuencial de los MHz pasa a un segundo plano. Si el controlador de memoria integrado (IMC) del procesador tiene que abrir y cerrar bancos de memoria de forma caótica, los tiempos de retardo acumulados por una latencia CAS alta se van sumando en cascada. El resultado es un cuello de botella invisible: tu tarjeta gráfica o tu procesador de IA se quedan hambrientos de datos, reduciendo la tasa de generación de tokens por segundo simplemente porque la memoria RAM no puede seguir el ritmo de las peticiones de direcciones de memoria.
Advertencia DatoCortex: En este año 2026, los perfiles de overclocking de memoria como Intel XMP 3.0 o AMD EXPO están empujando las frecuencias de DDR5 a límites peligrosos para el uso diario profesional. Comprar memorias de más de 7000 MHz suele requerir voltajes agresivos que estresan el controlador interno de la CPU, provocando micro-colapsos del sistema o corrupción silenciosa de datos durante ejecuciones largas de scripts de automatización. Para entornos estables de Inteligencia Artificial, la ingeniería dicta priorizar perfiles de baja latencia a frecuencias moderadas.
Arquitectura de bancos en DDR5 y la equivalencia real de acceso
Un motivo de confusión común al evaluar la evolución del almacenamiento temporal es por qué las memorias DDR5 presentan latencias CAS numéricamente más elevadas que las antiguas configuraciones DDR4. Esto responde a que la arquitectura DDR5 opera duplicando internamente tanto el número de bancos lógicos como la longitud de ráfaga (burst length) para consolidar anchos de banda masivos.
Aunque los valores nominales parezcan drásticamente más altos (como un registro CL30 frente a un CL16 de generación anterior), los ciclos de reloj en el estándar actual se ejecutan a una velocidad significativamente mayor debido a los elevados MHz del bus. Como consecuencia directa, el tiempo de acceso final medido en nanosegundos es matemáticamente equivalente o incluso inferior al de las mejores configuraciones del pasado, manteniendo la fluidez en el procesamiento.
Metodologías de diagnóstico técnico para timings en el sistema operativo
Para comprobar la latencia CAS real y el mapa de tiempos primarios de los módulos instalados sin depender de herramientas invasivas, la metodología técnica limpia dicta el uso de software de auditoría especializado. La alternativa estándar de la industria consiste en descargar la herramienta gratuita de diagnóstico de CPUID llamada CPU-Z.
Al navegar hacia la pestaña "Memory", el programa lee directamente los registros del hardware en tiempo real, exponiendo la frecuencia operativa real del bus la cual se debe multiplicar por dos debido a la naturaleza de la tecnología Dual Data Rate junto con el desglose exacto de los retardos del ciclo en el apartado "Timings".
Topología de canales: El impacto crítico de usar 2 vs 4 módulos en IA
Para maximizar el rendimiento sostenido durante la ejecución de modelos de Inteligencia Artificial local, el protocolo estricto de arquitectura de sistemas prohíbe poblar todos los slots de la placa base. Se debe emplear una configuración exclusiva de dos módulos de memoria instalados estrictamente en las ranuras optimizadas por el fabricante (habitualmente etiquetadas como los conectores A2 y B2).
Insertar cuatro módulos (sticks) satura eléctricamente el controlador de memoria integrado (IMC) alojado dentro de la CPU. Para preservar la integridad de la señal y la estabilidad del sistema bajo esta sobrecarga, el firmware de la placa base disminuye drásticamente la frecuencia operativa del bus y relaja las latencias en cascada, estrangulando por completo la velocidad de generación de tokens de los LLMs.
Especificación equilibrada para estaciones de trabajo con IA local
La recomendación de ingeniería para montar una estación de trabajo óptima orientada al procesamiento local de redes neuronales consiste en la adquisición de un kit de 64 GB de capacidad total, configurado mediante dos módulos simétricos de 32 GB cada uno. El perfil de rendimiento óptimo requiere una frecuencia nativa de 6000 MHz operando bajo un ajuste de latencia estricto de CL30.
Este emparejamiento garantiza una alta estabilidad en el controlador del procesador sin necesidad de forzar voltajes agresivos mediante perfiles extremos de Intel XMP o AMD EXPO. Al consolidar un tiempo de respuesta absoluto de exactamente 10 nanosegundos, el subsistema asegura el ancho de banda necesario para alojar modelos de parámetros intermedios directamente en la memoria del sistema, eliminando cuellos de botella y protegiendo la infraestructura contra corrupción silenciosa de datos.
Si quieres conocer otros artículos parecidos a Memoria RAM en 2026: Por qué la latencia CAS importa más que los MHz en la era de la IA local puedes visitar la categoría Hardware.
Deja una respuesta
Más contenido relacionado